Wie die OpenAI ChatGPT-Suche funktioniert: Was das LLM tut, bevor es antwortet
Kurz gefasst
GPT greift auf gelerntes Wissen und auf Informationen zurück, die es über Tools abruft. scaile hat 200 Codex-Durchläufe nachverfolgt, um zu verstehen, wie Suchen und Seitenprüfungen eine Antwort formen, und wo besserer Content einen Unterschied machen kann.
August GutscheCo-Founder und CPO
August ist Co-Founder und CPO von scaile und verantwortet das Produkt: die Recherche-, Schreib- und Publishing-Engine hinter Sichtbarkeit in der KI-Suche.
Wer verstehen will, wie ein großes Sprachmodell eine Frage beantwortet, muss zwei Dinge auseinanderhalten:
- Was es im Training gelernt hat.
- Was es während der Antwort über Tools findet.
Das Erste gibt dem Modell einen Ausgangspunkt. Das Zweite liefert Informationen, mit denen es diesen Ausgangspunkt prüfen, ergänzen oder korrigieren kann.
Für Marken ist das entscheidend. Eine gute Seite kann zu den Informationen gehören, die das Modell erhält, bevor es seine Antwort schreibt.
scaile hat diesen Prozess in Codex untersucht, dem Coding-Assistenten von OpenAI, und dafür die Suchen und Seitenaufrufe hinter GPT-Antworten nachverfolgt. Am 9. September 2026 hat scaile 100 Käuferfragen jeweils zweimal durch Codex laufen lassen und jede Suchanfrage, jeden Seitenaufruf und jede Prüfung innerhalb einer Seite aufgezeichnet, die das Modell vor seiner Antwort ausführte.
Das Training liefert Wissen. Tools liefern Informationen.
| Quelle | Was sie beiträgt |
|---|---|
| Training | Gelerntes Wissen, Sprachmuster und Assoziationen |
| Tool-Aufrufe | Informationen für die aktuelle Aufgabe, etwa Suchergebnisse und Seiteninhalte |
Tool-Aufrufe verändern die Trainingsdaten nicht. Sie fügen dem laufenden Gespräch Informationen hinzu, die die Antwort beeinflussen können. OpenAI unterscheidet hier zwischen gelerntem Wissen und Informationen, die im Kontext bereitgestellt werden. Erklärung von OpenAI
Wie das Modell beides nutzt, hängt außerdem vom Prompt, den Anweisungen und dem bisherigen Gesprächsverlauf ab.
Was passiert zwischen Prompt und Antwort?
Das Modell arbeitet in einem Harness: der Software, die ihm Anweisungen gibt, seine Tool-Aufrufe ausführt und die Ergebnisse zurückgibt.
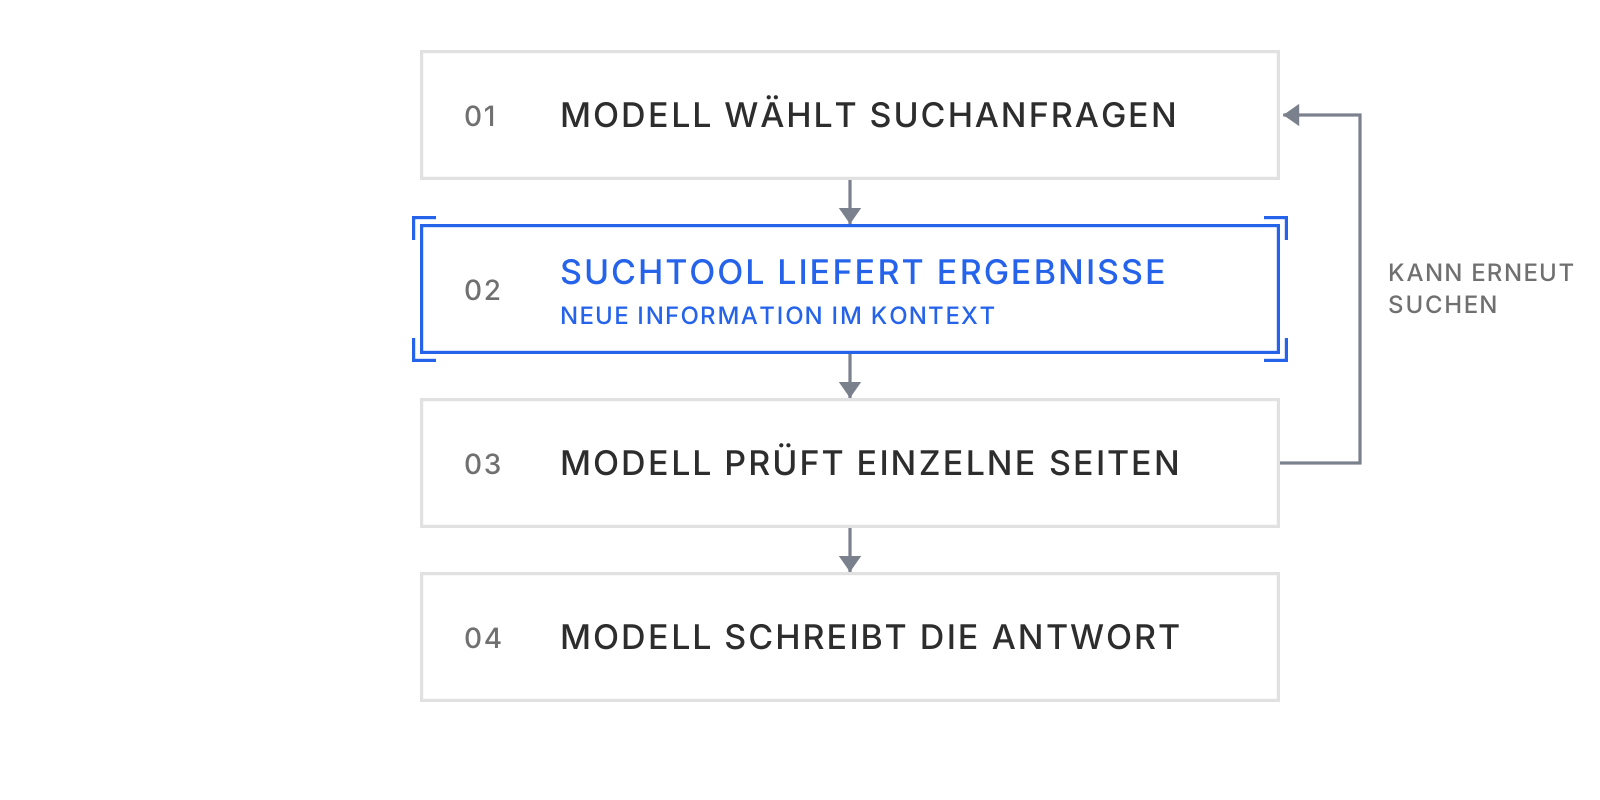
In der Untersuchung von scaile entschied das Modell früh, was es als Nächstes tut. Der Harness führte es aus. Die Web-Aktivität begann in der Regel mit Suchen, danach öffnete das Modell einzelne Seiten und prüfte Details:
- Suchen festlegen. Das Modell übersetzt die Aufgabe in Suchanfragen.
- Ergebnisse abrufen. Das Tool liefert Titel, URLs, Snippets und manchmal längere Auszüge.
- Einzelne Seiten prüfen. Das Modell öffnet Seiten, sucht innerhalb der Seiten oder stellt Folgeanfragen.
- Antwort schreiben. Das Modell nutzt sein vorhandenes Wissen und die Informationen, die die Tools geliefert haben.

Am 9. September 2026 hat scaile 100 Prompts jeweils zweimal ausgeführt:
| Beobachtung | Ergebnis |
|---|---|
| Durchläufe mit Web-Tools | 188 von 200 |
| Erster Web-Aufruf bestand nur aus Suchen | 180 dieser 188 |
| Zeit bis zur ersten Tool-Aktion, Median | 7,9 Sekunden |
| Seitenaufrufe je Durchlauf mit Websuche, Median | 5 |
Die erste Tool-Aktion konnte auch eine Rückfrage oder ein anderes Tool sein. Die Zeitangabe misst also nicht allein die Suche. Daten der Untersuchung.
Das Muster: Das System sammelt früh Informationen und prüft dann gezielt Details, bevor es antwortet. Das gilt für das getestete Setup, nicht zwingend für jedes GPT-Produkt und jeden Modus.
Warum die Suchebene für Content so wichtig ist
Die fertige Antwort zeigt nur, ob eine Marke vorkam. Die Tool-Aufrufe zeigen, welche Informationen auf dem Weg dorthin überhaupt verfügbar waren.
Welche Suchanfragen hat das Modell gewählt? Welche Seiten kamen zurück? Welcher Text wurde geliefert? Welche Seiten hat es anschließend geöffnet?
In einem aufgezeichneten Durchlauf zur Umsetzung von SEO- und GEO-Arbeit suchte das Modell nach Content-Workflows und CMS-Publishing, öffnete Startseiten, Preisseiten und Dokumentationen von Anbietern und suchte anschließend innerhalb dieser Seiten nach Begriffen wie Publish und $.
Für ein Content-Team ergibt sich daraus eine sehr konkrete Frage: Beantwortet die Seite klar die Frage nach Funktionen oder Preisen, die das Modell gerade prüft?
Das Vorwissen beeinflusst die Suchen. Die gelieferten Inhalte beeinflussen die nächsten Suchen und die Antwort. Wer diese Schleife versteht, erkennt, welche Content-Änderungen einen Test wert sind. OpenAI beschreibt diesen Ablauf aus Suchen, Ergebnisse sichten und Weitersuchen selbst. Leitfaden zur Websuche
Ein Durchlauf, von der Käuferfrage bis zum Content-Test
Hier ist dieser Durchlauf vollständig, so wie scaile ihn aufgezeichnet hat. Die Anbieternamen in den Suchanfragen des Modells sind durch <Anbieter> ersetzt, alles andere ist wörtlich wiedergegeben.
| Schritt | Was die Aufzeichnung zeigt |
|---|---|
| Käuferfrage | „What is the best tool for executing on my SEO and GEO data to actually become visible in AI search?“ |
| Erste Suchanfragen | AI search optimization platform execute recommendations content technical SEO <Anbieter> <Anbieter> <Anbieter>, danach je eine Anfrage pro Anbieter wie site:<Anbieter> AI search content workflows integrations |
| Folgeanfrage | site:<Anbieter> integrations Google Search Console Semrush Ahrefs CMS publish |
| Geöffnete Seiten | Die Startseite des Anbieters, seine Preisseite, die Startseite seiner Dokumentation, dann die Integrationsseite innerhalb der Dokumentation, dann die Preisseite eines Wettbewerbers |
| Wonach es innerhalb dieser Seiten suchte | Publish, publish, $, Solo, Agents |
| Content-Änderung zum Testen | Eine Integrationsseite, die die CMS-Anbindungen und den Veröffentlichungsschritt in klaren Worten benennt, und eine Preisseite mit Plannamen und Preis, damit die Prüfungen des Modells auf „publish“ und „$“ echten Text treffen |
Das Modell hat den Anbieter nie gebeten, sich selbst zu beschreiben. Es hat gefragt, ob das Produkt an ein CMS anbindet und veröffentlicht und was das kostet, und genau diese zwei Punkte auf den geöffneten Seiten geprüft. Eine Seite, die beides ausdrücklich beantwortet, ist der Content-Test, den scaile für diese Käuferfrage zuerst durchführen würde.
Mit Alpha kann scaile einen Schritt direkt untersuchen
Im untersuchten Codex-Setup gingen die Web-Tool-Anfragen an:
POST https://chatgpt.com/backend-api/codex/alpha/searchEin Endpunkt ist eine Adresse, an die Software ihre Anfragen schickt. Alpha akzeptiert einen direkten Suchbefehl. Dieser Teil der Anfrage legt die Suchanfrage fest:
{
  "commands": {
    "search_query": [{ "q": "Software Agentur Wien" }]
  }
}
scaile kann so die gelieferten Seiten prüfen, ohne dass ein Modell die Suchanfrage wählt oder eine Antwort schreibt.
Eine Ebene tiefer zu gehen bedeutet, den Suchschritt von den Entscheidungen zu trennen, die das Modell davor und danach trifft.
Probieren Sie es mit Ihrer eigenen Website: Der kostenlose GPT Search Check schickt Ihre Domain und bis zu drei Suchanfragen an diesen Endpunkt und sendet Ihnen die gelieferten Seiten per E-Mail.

Was ist der Unterschied zu Responses?
Bei der öffentlichen Responses API geben Sie dem Modell einen Prompt und schalten die Websuche frei. Den Suchaufruf formuliert das Modell selbst.
| Frage | Alpha | Responses mit Websuche |
|---|---|---|
| Wie kommt die Suchanfrage zum System? | Direkt als Suchbefehl | Über Anweisungen an das Modell |
| Lassen sich die gelieferten Seiten einsehen? | Ja | Ja, auf Anforderung |
| Hat scaile Auszüge und Crawl-Angaben erhalten? | Ja | Ja |
| Wofür in dieser Untersuchung genutzt | Eine exakte Suchanfrage prüfen | Such- und Antwortprozess des Modells prüfen |
Responses liefert die Ergebnisse im Detail über web_search_call.results und die Quell-URLs über web_search_call.action.sources. Die tatsächlich gestellte Suchanfrage steht in action.queries. Responses-Referenz
Im Vergleich vom 17. September hat jeder Aufruf der öffentlichen API die gewünschte Suchanfrage exakt übernommen. Der Unterschied bei Alpha ist die direkte Steuerung per Befehl, statt darauf zu vertrauen, dass das Modell die Anweisung befolgt.
Die Ergebnislisten unterschieden sich trotzdem. Für Software Agentur Wien lieferte der erste gepaarte Versuch 27 Ergebnisse über Alpha und 21 über Responses, davon 16 identische URLs. Weil die Ausgabelimits unterschiedlich gesetzt waren, lässt sich daraus nicht ableiten, warum die Listen abweichen. Vergleichsdaten.
Aus den Suchdaten Content-Tests ableiten
Wer die Tool-Aufrufe auswertet, macht aus „in der GPT-Antwort vorkommen“ konkrete Arbeit:
| Was die Aufzeichnung zeigt | Content-Änderung zum Testen |
|---|---|
| Die Suchanfragen zielen auf eine bestimmte Aufgabe | Erklären, wie das Produkt genau diese Aufgabe löst |
| Im gelieferten Text fehlt eine zentrale Funktion | Diese Funktion auf den passenden Seiten ausdrücklich benennen |
| Das Modell prüft Preise oder Integrationen | Klare, aktuelle Angaben mit Belegen bereitstellen |
| Die Seite erscheint, die Marke wird aber nicht empfohlen | Prüfen, ob die Seite die Anforderungen des Nutzers wirklich abdeckt |
Das sind Hypothesen. Die Aufzeichnungen verraten keine vollständige Ranking-Formel und beweisen nicht, dass ein bestimmter Schreibstil zu einer Empfehlung führt.
Halten Sie die Käuferfragen konstant, ändern Sie einen inhaltlichen Teil des Contents, wiederholen Sie die Prüfungen und vergleichen Sie mit einer unveränderten Seite. Messen Sie getrennt, ob eine Seite gefunden, zitiert und empfohlen wird.
Verstehen, wonach das Modell sucht. Die Belege verbessern, die es finden kann. Messen, ob sich die Antwort dadurch ändert. Das ist die Chance, die diese Untersuchung eröffnet.
Nächster Schritt: Der kostenlose GPT Search Check von scaile liefert die Seiten, die der Suchindex von OpenAI für Ihre Domain und bis zu drei Suchanfragen Ihrer Wahl ausgibt. Es ist derselbe Suchschritt, den diese Untersuchung geprüft hat, ausgeführt für Ihre Website.
Umfang der Untersuchung: Die Prozessstudie lief mit Codex und gpt-6-astra bei xhigh effort am 9. September 2026. Der separate Alpha/Responses-Vergleich umfasste fünf Alpha- und sechs öffentliche API-Anfragen am 17. September. Die Beobachtungen beschreiben konkrete Setups, kein allgemeingültiges ChatGPT-Ranking und keinen kontrollierten Nachweis, dass Content-Änderungen die Antworten verbessern.