Wie ChatGPT lokale Unternehmen findet
Kurz gefasst
Wir haben die SSE-Streams von ChatGPT ausgewertet, um zu verstehen, wie die Suche nach lokalen Unternehmen funktioniert. Wir fanden Unternehmensdaten, die weitgehend mit Google Maps übereinstimmen, dazu umgeschriebene Websuchen und unterschiedliche Darstellungen der Ergebnisse.
August GutscheCo-Founder und CPO
August ist Co-Founder und CPO von scaile und verantwortet das Produkt: die Recherche-, Schreib- und Publishing-Engine hinter Sichtbarkeit in der KI-Suche.
Wichtige Erkenntnisse
100 % (12/12): der Haupt-Prompts mit Empfehlung und Stadtnennung erzeugten Karten.
50 % (6/12): enthielten Bewertungen in den sichtbaren Suchanfragen.
100 % (4/4): der mit Google abgeglichenen Apothekendatensätze hatten dieselbe Bewertung und dieselbe Anzahl an Rezensionen.
Unsere Hypothese: Die Suche nach einem lokalen Unternehmen funktioniert anders als eine allgemeine Frage an ChatGPT.
Um das zu prüfen, haben wir 50 Gespräche aus 12 Branchen getestet und die Antworten ausgewertet, die an den Browser gesendet werden. Sie kommen als Server-Sent Events (SSE): ein Datenstrom aus Updates mit Teilen der Antwort, Suchmetadaten und Unternehmensdatensätzen.
Die Studie umfasst 36 Haupttests (12 Branchen × 3 Prompt-Typen), 8 Wiederholungstests und 6 Tests zur Formulierung bei Apotheken. Die Gesamtwerte unten beziehen sich auf alle 50 Gespräche; Prompt-Vergleiche nutzen die jeweils passende Teilmenge.
Die Bezugsgrößen unterscheiden sich: 12 Haupt-Prompts mit Stadt gegenüber vier abgeglichenen Unternehmen aus einer Antwort. Diese Prozentwerte beschreiben unsere Tests.
Was passiert, wenn Sie nach einem lokalen Unternehmen suchen
Gehen wir ein echtes Beispiel aus dem Experiment durch.
1. Der Nutzer stellt eine Frage
Wir haben diesen Prompt in ein frisches ChatGPT-Gespräch eingegeben:
Welche Apotheken in München empfiehlst du?
Which pharmacies in Munich do you recommend?
Der Browser hat ihn gesendet über:
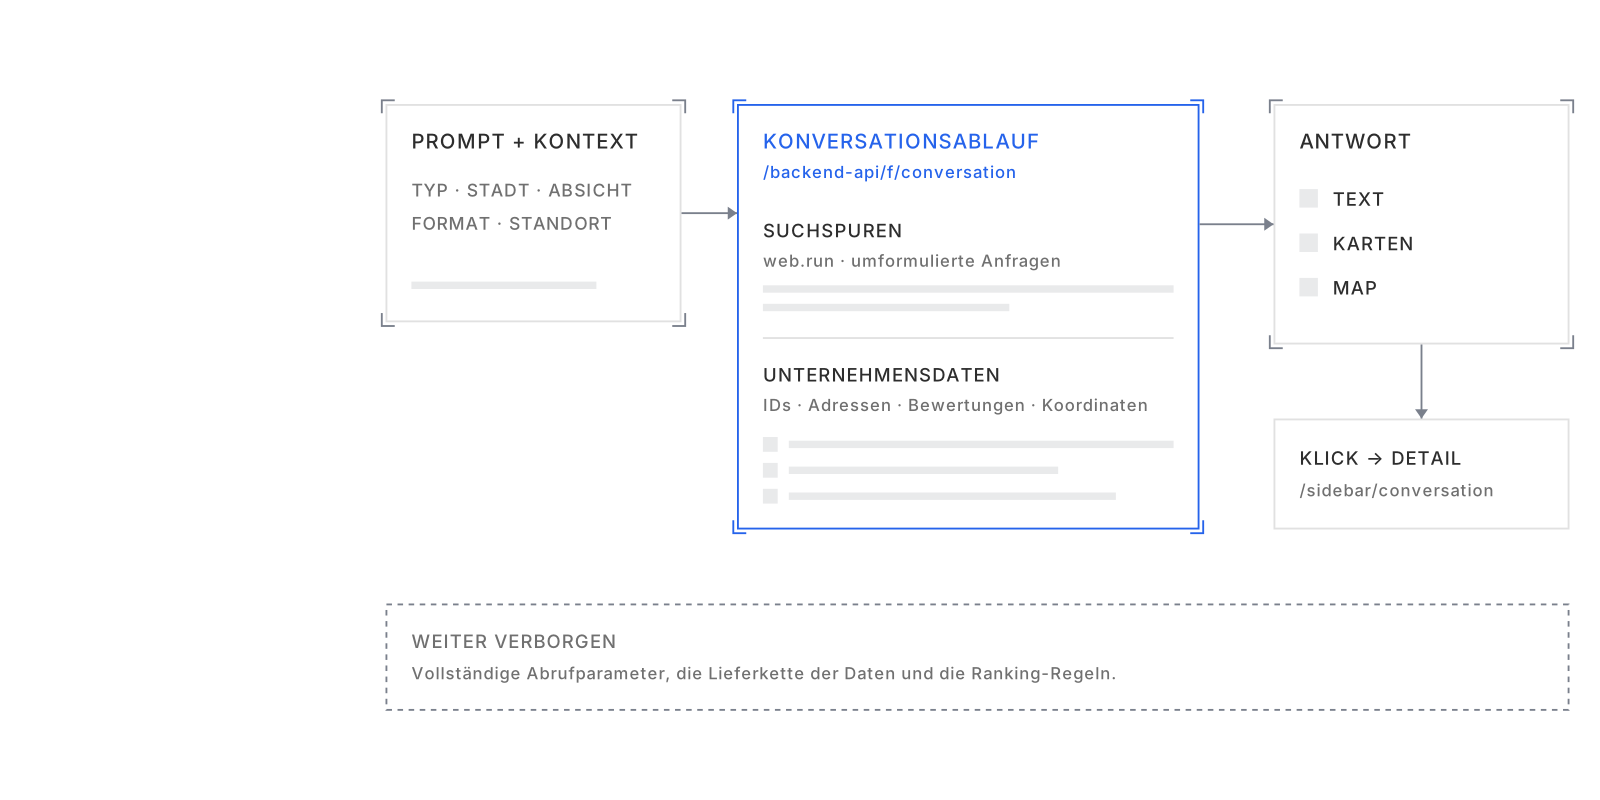
POST /backend-api/f/conversationDas ist der Gesprächs-Endpunkt, den wir beobachtet haben. Die Frage steht im Request-Body unter messages[].content.parts.
2. ChatGPT entscheidet, wie es antwortet
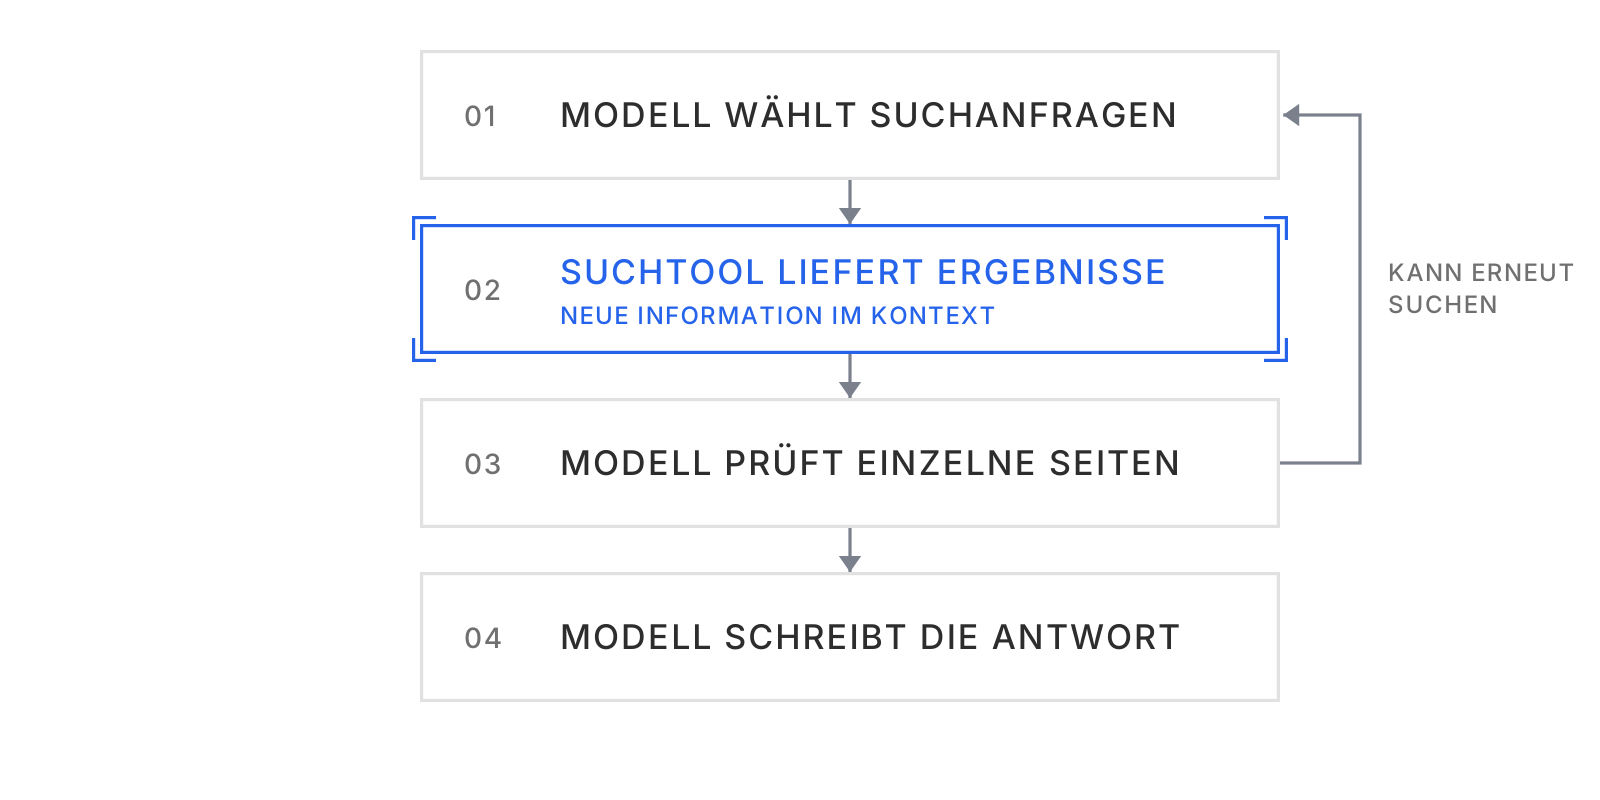
ChatGPT kann direkt antworten, nach einem Standort fragen oder nach Optionen suchen. Das Modell und die Software drumherum, der sogenannte Harness, steuern dieses Verhalten.
Wir sehen, welche Antwort entsteht. Der Stream legt weder die vollständige Entscheidungslogik offen noch trennt er die Entscheidungen des Modells von denen des Harness.
3. ChatGPT formuliert die Frage zu Suchanfragen um
Unser Apotheken-Prompt wurde in den sichtbaren Metadaten zu diesem Suchstring:
München Apotheke Hauptbahnhof Marienplatz Öffnungszeiten Apotheke offiziell 2026ChatGPT ergänzte konkrete Orte, Öffnungszeiten, „offiziell“ und eine Jahreszahl. Die Anfrage stand in einem Feld namens search_model_queries.
Dasselbe Feld haben wir über alle 12 Haupttests mit Stadtempfehlung geprüft. Mit den sechs wiederholten Stadt-Prompts ergeben sich insgesamt 18 Gespräche mit Stadtsuche; deren Zahlen zeigen wir getrennt, damit häufig wiederholte Branchen den Hauptvergleich nicht verzerren.
| Zusatz in der Suchanfrage | 12 Haupttests mit Stadt | Alle 18 Tests mit Stadt |
|---|---|---|
| Jahr 2026 | 10/12 · 83 % | 15/18 |
| „Beste“ oder seriös | 7/12 · 58 % | 10/18 |
| Rezensionen oder Bewertungen | 6/12 · 50 % | 7/18 |
| Benannte Ratgeber oder Institutionen | 3/12 · 25 % | 3/18 |
| Öffnungszeiten | 1/12 · 8 % | 2/18 |
Jeder Test zählt einmal pro Kategorie; Kategorien überschneiden sich. 13 sichtbare Strings in 12 Haupttests mit Stadt. Beobachtete Suchanfragen sind keine nachgewiesenen Ranking-Faktoren.
Die Ergänzungen waren branchenspezifisch. Die Zahnarzt-Anfrage enthielt jameda und Doctolib. Bei Restaurants kam der Michelin Guide dazu. Bei Klempnern die Handwerkskammer.
Auch die Sprache wechselte: Aus unserem deutschen Hotel-Prompt wurde eine englische Anfrage mit „luxury“, „boutique“, „central“, „affordable“ und „reviews“.
4. ChatGPT ruft ein Tool auf
Im Apotheken-Beispiel zeigte der Stream zwei Assistenten-Nachrichten an web.run. Dies ist ein gekürzter Auszug einer Nachricht:
{
  "author": { "role": "assistant" },
  "recipient": "web.run"
}
In allen 50 Gesprächen zeigten 28 Suchaktivität, insgesamt mit 39 sichtbaren web.run-Aufrufen. Ein sichtbarer Aufruf entspricht nicht zwingend genau einer zugrunde liegenden Suchanfrage.
Wir sahen web.run sowohl in Antworten mit Karte als auch in Antworten ohne Karte. Das Feld map_search_model_queries tauchte ebenfalls auf, ist aber ein Metadatenfeld und kein Beleg für ein eigenes, aufrufbares Karten-Tool.
5. ChatGPT liefert Unternehmensdaten und eine Antwort
Die normale Apotheken-Antwort zeigte fünf Orte auf der Karte. Ihr Stream enthielt strukturierte Datensätze wie diesen:
{
  "id": "ChIJ0zyJSvp1nkcRi483DLeru3Y",
  "provider": "serp",
  "name": "Inter Apotheke",
  "address": "Elisenstraße 5, 80335 München, Germany",
  "latitude": 48.1418702,
  "longitude": 11.561119099999999,
  "rating": 4.8,
  "review_count": 130,
  "website_url": "http://www.inter-apotheke.de/",
  "ranking_score": null
}
Die Antwort verbindet schriftliche Empfehlungen mit Unternehmenskarten und einer Karte. Der Datensatz liefert der Oberfläche die Fakten zum Unternehmen. ranking_score: null bedeutet, dass dieser Datensatz keinen Ranking-Wert offenlegt.
Auch eine reine Textantwort kann die Websuche nutzen. Als wir ausdrücklich keine Karte und keine Unternehmenskarten verlangten, zeigte ChatGPT einen Web-Aufruf und empfahl sechs Apotheken als Text.

6. Ein Klick auf ein Unternehmen öffnet eine separate Detailanfrage
Der beobachtete Detail-Ablauf nutzte:
POST /backend-api/sidebar/conversationDiese Anfrage identifiziert ein bestimmtes Unternehmen über Name und Standort bzw. Adresse, zusammen mit Gesprächs- und Nachrichten-IDs. Sie ruft mehr Details zu genau diesem Unternehmen ab. Die Suche nach der Kategorie lief über den oben beschriebenen Gesprächs-Ablauf.
Standortparameter in der Gesprächsanfrage getestet
Wir haben außerdem getestet, dieses Objekt auf oberster Ebene in den JSON-Body von POST /backend-api/f/conversation einzufügen:
{
  "map_search_params": {
    "latitude": 48.137154,
    "longitude": 11.576124,
    "latitude_span": 0.05,
    "longitude_span": 0.08,
    "search_here": true
  }
}
Die Koordinaten bezeichnen einen öffentlichen Punkt im Zentrum von München. Die Feldnamen legen einen Suchbereich um diesen Punkt nahe: latitude_span und longitude_span beschreiben seine Ausdehnung, search_here scheint eine Suche in diesem Bereich anzufordern. Diese Deutungen sind kein dokumentierter API-Vertrag und kein verifizierter Entfernungsfilter.
Das Objekt liefert Standortkontext; die eigentliche Suchanfrage, etwa „Welche Apotheken in München empfiehlst du?“, steht weiterhin in messages[].content.parts. Der obige Ausschnitt ist eine Ergänzung der vollständigen Gesprächsanfrage, keine vollständige eigenständige Anfrage.
Unser Test mit Apotheken-Parametern wurde abgeschlossen und lieferte 11 Place-IDs mit Beschreibungen, die Karte wurde aber nicht angezeigt. Das bestätigt eine Antwort auf diese veränderte Anfrage. Es beweist nicht, dass jeder Parameter den Abruf beeinflusst hat, garantiert keine Ergebnisse innerhalb des Bereichs und belegt keine funktionierende öffentliche Karten-API.
map_search_params ist das Anfrageobjekt, das wir im separaten Parametertest mitgeschickt haben. map_search_model_queries sind Anfragemetadaten, die wir in Antworten beobachtet haben. Keines der 50 normalen Gespräche der Hauptstudie enthielt dieses Objekt.
Welche Suchen Karten erzeugten
Unser ausgewogenes Hauptpanel testet drei Prompt-Typen in 12 Branchen: eine Empfehlung mit Nennung von München, eine Empfehlung ohne Stadt und eine Definitionsfrage. Wiederholungstests zählen wir getrennt.
| Branche | Empfehlung + München | Empfehlung, ohne Stadt | Definitionsfrage |
|---|---|---|---|
| Apotheken | Karte · 5 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Restaurants | Karte · 8 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Zahnärzte | Karte · 6 Orte | Karte · 5 Orte | Keine sichtbare Suche |
| Klempner | Karte · 5 Orte | Karte · 5 Orte | Keine sichtbare Suche |
| Steuerberater | Karte · 6 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Hotels | Karte · 6 Orte | Nur Websuche | Keine sichtbare Suche |
| Autowerkstätten | Karte · 6 Orte | Karte · 6 Orte | Keine sichtbare Suche |
| CRM-Software | Karte · 5 Orte | Nur Websuche | Keine sichtbare Suche |
| Bäckereien | Karte · 6 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Friseursalons | Karte · 7 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Fitnessstudios | Karte · 6 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
| Blumenläden | Karte · 6 Orte | Keine sichtbare Suche | Keine sichtbare Suche |
36 Haupttests, einer pro Zelle. Suche = sichtbarer web.run-Aufruf; Karte = angezeigte Karte.
Karten erschienen bei 100 % (12/12) der Empfehlungen mit Stadt, bei 25 % (3/12) ohne Stadt und bei 0 % (0/12) der Definitionsfragen.
Selbst Anbieter von CRM-Software erzeugten eine Karte, sobald der Prompt München nannte. Neben der Branche zählte also der lokale Bezug.
Zahnärzte, Klempner und Autowerkstätten erzeugten Karten auch ohne Stadt im Prompt. In der Zahnarzt-Antwort sagte ChatGPT, München sei unser ungefährer Standort. Der Mitschnitt belegt nicht, ob dieser Standort aus einer IP-Adresse oder einer anderen Quelle stammte.
In den acht neuesten Tests fragten alle vier Empfehlungen ohne Stadt zurück, wo wir suchen möchten. Die vier Definitionsfragen wurden direkt beantwortet. Keiner dieser Tests zeigte einen Web-Aufruf oder eine Karte. Bei denselben Branchen hatten die früheren Varianten mit Stadt alle Karten erzeugt.
Anschließend haben wir die Formulierung bei Apotheken variiert:
| Prompt | Sichtbare Web-Aufrufe | Orte auf der Karte |
|---|---|---|
| „Apotheke“ | 0 | 0; Rückfrage |
| „Welche Apotheken in meiner Nähe empfiehlst du?“ | 1 | 5 |
| „Apotheken in München“ | 1 | 4 |
| „Welche Online-Apotheken empfiehlst du?“ | 2 | 0 |
| „Welche Apotheken in München empfiehlst du? Antworte nur als Text, ohne Karte oder Unternehmenskarten.“ | 1 | 0 |
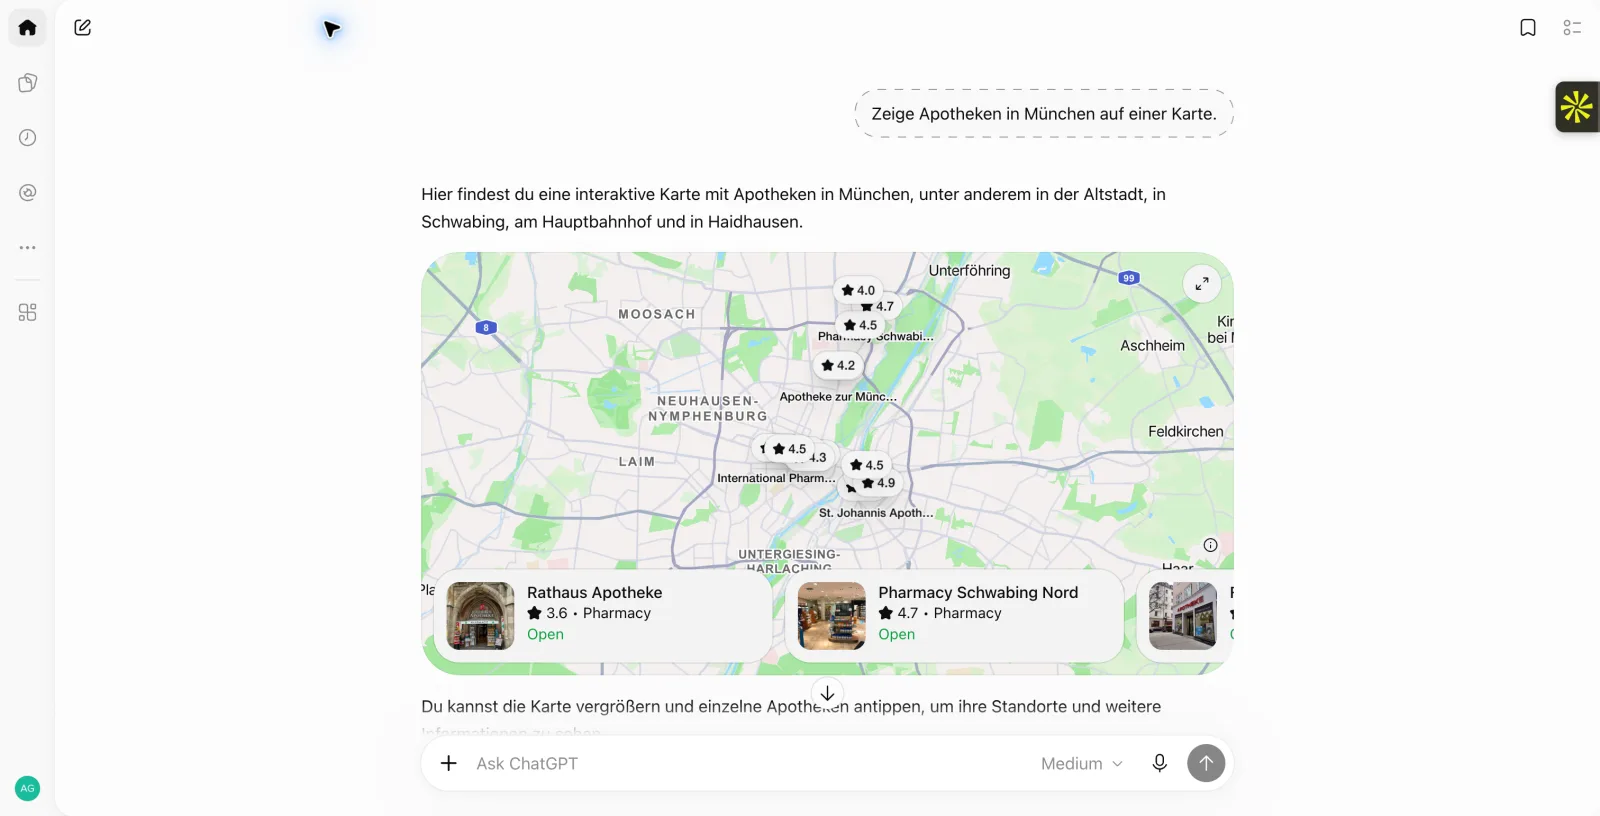
| „Zeige Apotheken in München auf einer Karte.“ | 1 | 14 |
Sechs explorative Folgetests, je ein Durchlauf.
Das Ausgabeformat folgte der Anweisung. In einem früheren, separaten Test zeigten 100 % von acht Standardantworten Karten, gegenüber 0 % von acht reinen Textantworten, über vier Branchen hinweg. Das misst, was auf dem Bildschirm erschien; es belegt nicht, dass im Hintergrund kein Ortsabruf stattfand.
Wie ähnlich sind die Ergebnisse zu Google Maps?
Wir haben Unternehmensdaten und Unternehmensauswahl getrennt verglichen.
Die Unternehmensdaten stimmten in unseren kleinen Stichproben überein
Vier der fünf Apotheken in der normalen ChatGPT-Antwort tauchten in den ersten 20 erfassten Google-Maps-Ergebnissen auf. Bewertungen und Rezensionszahlen stimmten in 100 % dieser vier Fälle überein.
| Unternehmen | Bewertung bei beiden | Rezensionen bei beiden |
|---|---|---|
| Inter Apotheke | 4,8 | 130 |
| Apotheke Maxvorstadt | 4,7 | 105 |
| Dr. Beckers Central Apotheke | 4,5 | 270 |
| Barer Apotheke | 4,7 | 116 |
Das fünfte Unternehmen fehlte in den ersten 20 erfassten Google-Ergebnissen.
Eine frühere Prüfung von acht ausgewählten Unternehmen aus acht Branchen ergab ebenfalls eine 100-prozentige Übereinstimmung bei Bewertungen, Rezensionszahlen und auf sechs Nachkommastellen gerundeten Koordinaten. Google wurde 63–76 Minuten später geprüft.
Die Unternehmenslisten unterschieden sich
Eine separate Anfrage mit eingeschleusten Kartenparametern lieferte 11 Place-IDs. Davon erschienen 90,9 % (10/11) in Googles ersten 20 organischen Ergebnissen für dieselbe Empfehlungsformulierung. Bei „Apotheken München“ lag die Überschneidung bei 54,5 % (6/11).
| Google-Maps-Suchanfrage | ChatGPT-Place-IDs in Googles ersten 20 |
|---|---|
| Gleiche Empfehlungsformulierung | 10/11 · 90,9 % |
| Kurze Kategorie-Anfrage | 6/11 · 54,5 % |
Dieser Parametertest lieferte IDs und Beschreibungen, die Karte wurde aber nicht angezeigt. Er ist von den normalen Chat-Tests getrennt. Google-Ausschnitte, Spracheinstellungen und Erfassungszeitpunkte waren nicht vollständig angeglichen. Das ist eine Überschneidung der Identitäten, kein kontrollierter Ranking-Vergleich.
Auch die Reihenfolge wich ab. Die ersten drei ChatGPT-IDs standen bei Google auf den Positionen 3, 5 und 13. Diese Unterschiede lassen sich nicht allein auf die Formulierung zurückführen.
Die übereinstimmenden Fakten und IDs sprechen für eine Verbindung zu Google-kompatiblen Unternehmensdaten. Sie benennen weder den Lieferanten noch beweisen sie einen direkten Aufruf der Google-API. Das Label serp reicht für keines von beidem.
Dasselbe Hotel fanden wir außerdem unter zwei Anbieter-Labels: serp und tripadvisor-feed. Beide Bewertungen lagen bei 4,4, die Rezensionszahlen aber bei 1.872 und 1.078. Die Datensätze zeigen, dass mehr als eine Datenquelle auftauchen kann.
Yelp kannte dieselben Unternehmen, aber mit anderen Rezensionszahlen
Wir haben außerdem vier Unternehmen anhand von Name und Straßenadresse mit aktiven Yelp-Seiten abgeglichen. Alle vier Adressen stimmten überein; drei Telefonnummern stimmten nach der Formatierung überein. Die Rezensionsdaten wichen ab:
| Unternehmen und Yelp-Quelle | ChatGPT Bewertung / Rezensionen | Yelp Bewertung / Rezensionen |
|---|---|---|
| Inter Apotheke | 4,8 / 130 | 1,0 / 1 |
| Wirtshaus in der Au | 4,5 / 6.059 | 4,2 / 284 |
| Cortiina Hotel | 4,5 / 593 | 4,3 / 28 |
| Brotraum | 4,7 / 559 | 4,7 / 29 |
Vier ausgewählte Treffer aus Apotheken, Restaurants, Hotels und Bäckereien; keine zufällige Stichprobe. Aktive Yelp-Seiten am 9. Oktober geprüft, nach den ChatGPT-Mitschnitten.
Nur eine von vier Bewertungen stimmte überein, und keine der vier Rezensionszahlen. Brotraum zeigt, warum eine übereinstimmende Sternebewertung allein ein schwacher Beleg ist: Beide zeigten 4,7, die Rezensionssummen lagen aber bei 559 und 29.
Wir haben alle 50 erfassten Gespräche durchsucht. Über 146 Auftritte von Kartendatensätzen lauteten die Anbieter-Labels in 142 Fällen serp, in 1 Fall tripadvisor-feed und in 3 Fällen leer. In den rekonstruierten Nachrichten fanden wir keine Yelp-URLs und keine befüllten Yelp-spezifischen Felder. Ein Schemafeld wie yelp_menu_url: null ist kein Beleg für Yelp-Daten.
Diese Tests belegen überschneidende Unternehmen und abweichende angezeigte Rezensionsdaten. Eine indirekte Nutzung von Yelp an anderer Stelle der Abrufkette können sie nicht ausschließen.
Was die einzelnen Unternehmensdatensätze verraten
In der gesamten Studie mit 50 Gesprächen haben wir 146 Auftritte von Kartendatensätzen aus 24 Gesprächen mit Karte extrahiert. Die 12 Haupt-Stadtempfehlungen enthielten 72 Kartenpunkte, darunter zwei generische Punkte ohne Bewertung. Wiederholte Auftritte zählen in den Gesamtwerten der Studie einzeln.
Die beste Bewertung stand meist nicht an erster Stelle
Von den 12 Haupt-Stadtlisten hatten 11 für jeden Kartenpunkt eine Bewertung. In 10/11 dieser vollständigen Listen hatte ein weiter hinten platziertes Unternehmen eine bessere Bewertung als das erste. Eine von 11 folgte einer absteigenden Bewertungsreihenfolge; keine von 11 folgte einer absteigenden Reihenfolge nach Rezensionszahl.
Die Apothekenliste begann mit einem Unternehmen mit 4,8, gefolgt von einem mit 4,9. Bei den Zahnärzten lag der Start bei 4,8, während die letzten beiden Unternehmen 4,9 hatten.
Diese Ergebnisse schließen eine allgemeine Sortierung nach bester Bewertung zuerst aus. Wie stark Rezensionen die Auswahl oder das Ranking beeinflussen, sagen sie nicht.
Ein Unternehmen auf der Karte muss nicht mit seiner Website in den sichtbaren Webergebnissen stehen
Über alle Auftritte von Kartendatensätzen hatten 138 eine Website-URL. Nur 15,2 % (21/138) dieser Website-Hosts erschienen auch in den sichtbaren Web-Ergebnis-URLs des jeweiligen Durchlaufs. Allein in den 12 Haupt-Stadtlisten lag die Überschneidung bei 16,2 % (11/68). Wir haben Hostnamen nach dem Entfernen von www. abgeglichen. Das sind Zählungen von Auftritten, keine unabhängigen Unternehmen.
Im Apotheken-Beispiel erschien kein Website-Host der fünf Unternehmen auf der Karte in den sichtbaren Webergebnissen. Ein Unternehmen kann also auf der Karte stehen, ohne dass dieser sichtbare Website-Treffer existiert. Der Stream legt nicht jeden Abrufschritt offen, und Seiten Dritter können dasselbe Unternehmen abdecken.
Karte und schriftliche Empfehlungen können sich unterscheiden
In 11/12 Haupttests mit Stadt stimmten IDs und Reihenfolge der Unternehmen auf der Karte mit den Unternehmenskomponenten in der Antwort überein. Die Ausnahme bei den Bäckereien enthielt generische Kartenpunkte. Unabhängig davon enthielt der wiederholte CRM-Test sechs Unternehmen in der Antwort, aber fünf auf der Karte: Shore wurde als zusätzliche Empfehlung in einem Satz genannt und fehlte auf der Karte.
Wer nur Kartenpins misst, übersieht eine solche Empfehlung. Reine Textnennungen, Unternehmenskomponenten, Karten und Quellenangaben verdienen getrennte Zählungen.
Die Datensätze enthalten nützliche Fakten, aber keinen Ranking-Wert
| Feld über alle 146 Auftritte von Kartendatensätzen | Auftritte mit Wert |
|---|---|
| Bewertung und Rezensionszahl, jeweils | 97,9 % · 143/146 |
| Telefonnummer | 97,9 % · 143/146 |
| Website-URL | 94,5 % · 138/146 |
| Öffnungszeiten | 93,2 % · 136/146 |
| Ranking-Wert | 0 % · 0/146 |
| Einzelne Rezensionen und Rezensions-Highlights, jeweils | 0 % · 0/146 |
Eine Rezensionssumme ist nicht der zugrunde liegende Rezensionstext. Fehlende Felder belegen auch nicht, dass dem Server diese Information fehlt.
Neu berechnet aus jedem abgeschlossenen Studiengespräch. Wir verwenden pro Durchlauf die eine sichtbare Endantwort und schließen verborgene Nachrichtenfragmente aus, um Doppelzählungen zu vermeiden.
Wiederholte Stadt-Prompts veränderten die Auswahl
Die gesamte Studie enthält für Bäckereien, Friseursalons, Fitnessstudios und Blumenläden je zwei identische Stadtempfehlungs-Prompts, zusätzlich zu den Wiederholungen bei Apotheken und CRM. Jeder Durchlauf nutzte einen frischen, temporären, nicht personalisierten Chat. Das Anfragemodell war gpt-6-thinking; die Oberfläche zeigte Medium an.
Alle 18/18 Gespräche mit Stadtempfehlung, Wiederholungen eingeschlossen, erzeugten Karten. Die sechs wiederholten Branchenpaare sahen so aus:
| Branche | Kartenpins erster / zweiter Durchlauf | Gemeinsame Einträge |
|---|---|---|
| Apotheken | 5 / 6 | 4 |
| CRM-Software | 5 / 5 | 4 |
| Bäckereien | 6 / 6 | 2 |
| Friseursalons | 7 / 7 | 4 |
| Fitnessstudios | 6 / 5 | 2 |
| Blumenläden | 6 / 6 | 3 |
Wir gleichen stabile Anbieter-IDs ab, ersatzweise exakt normalisierte Namen und auf fünf Nachkommastellen gerundete Koordinaten. Filialen zählen einzeln.
Beide Bäckerei-Antworten hatten sechs Pins, teilten aber nur zwei physische Einträge. Selbst wenn eine Marke wiederkehrte, konnte sich die gewählte Filiale ändern: Dompierre wechselte von der Türkenstraße zur Tengstraße.
Auch die Suchstrings änderten sich. Die erste Bäckerei-Anfrage ergänzte „Sauerteig“ und „Brezen“. Die Wiederholung nannte Julius Brantner, Neulinger und Dompierre. Die erste Fitnessstudio-Anfrage nannte bereits FitX, Fit Star, McFIT, body + soul, Fitness First und Elements. Diese Markennamen standen nicht in unseren Prompts.
Ein Kartenpin enthält nicht immer einen vollständigen Unternehmensdatensatz
Die erste Bäckerei-Antwort zeigte sechs Orte auf der Karte. Vier kamen über referenzierte Unternehmensdatensätze. Die anderen beiden wurden der Kartenkomponente als Name und Adresse übergeben, darunter dieses Objekt:
{
  "id": "gat",
  "name": "Bäckerei Gattinger",
  "address": "Johann-Clanze-Straße 104, 81369 München"
}
Der zurückgegebene Punkt hatte Koordinaten und eine ID mit map-widget-point-, aber ein leeres Anbieter-Label und weder Bewertung noch Rezensionszahl. Welcher Geocoder die Koordinaten lieferte, konnten wir nicht klären.
Das ist ein weiterer Grund, nicht jeden Pin als Beleg für einen vollständigen Eintrag im Google-Stil zu werten.
Warum derselbe Prompt andere Unternehmen liefern kann
Wir haben den exakt gleichen Münchner Apotheken-Prompt in einem frischen Gespräch wiederholt. Der erste Durchlauf zeigte fünf Orte auf der Karte und zwei Web-Aufrufe. Der zweite zeigte sechs Orte und einen Aufruf.
Vier Unternehmen erschienen in beiden Antworten, bei insgesamt sieben verschiedenen Unternehmen im Paar. Sowohl die sichtbare Suchaktivität als auch die Auswahl änderten sich.
Der Stream verrät nicht, wie viel davon auf die Variabilität der Generierung, auf Änderungen beim Abruf oder auf verborgene Ranking-Logik zurückgeht. Er zeigt aber, warum eine einzelne Antwort zu wenig ist, um sie als dauerhaftes Ranking zu behandeln.
Was das für lokale Unternehmen bedeutet
Die Beobachtungen weisen auf Unternehmensprofile, lokale Website-Inhalte und Einträge Dritter als praktische Ansatzpunkte hin. Den Effekt solcher Änderungen auf ChatGPT-Empfehlungen haben wir nicht gemessen.
Halten Sie Ihr Google-Unternehmensprofil korrekt
Prüfen Sie Kategorie, Adresse, Telefonnummer, Website und Öffnungszeiten. Pflegen Sie Sonderöffnungszeiten, aussagekräftige Fotos und echte Rezensionen. Die Übereinstimmung mit Google in unseren Stichproben macht das zu einer sinnvollen Priorität.
Google empfiehlt vollständige, korrekte Angaben und nennt Relevanz, Entfernung und Bekanntheit als Faktoren für das lokale Ranking. Das ist Googles Leitlinie, keine verifizierte ChatGPT-Ranking-Formel. Googles Leitlinie
Schreiben Sie Content für die lokalen Suchen, die ChatGPT tatsächlich stellt
Unsere Apotheken-Anfrage ergänzte Hauptbahnhof, Marienplatz und Öffnungszeiten. Ein Unternehmen mit relevantem Standort oder Angebot sollte das auf seiner Website klar erklären.
Veröffentlichen Sie nützliche Angaben zu Ihrem tatsächlichen Einzugsgebiet, Ihren Schwerpunkten, Ihrer Verfügbarkeit und Ihrem Buchungsablauf. Halten Sie zeitkritische Fakten aktuell. Dass „2026“ in 83,3 % (10/12) der Haupttests mit Stadtanfrage auftauchte, heißt nicht, dass eine Jahreszahl auf jeder Seite Ihre Position verbessert.
Halten Sie relevante Einträge Dritter aktuell
Die Zahnarzt-Anfrage nannte Jameda und Doctolib. Anfragen zu Restaurants und Handwerkern nannten andere Quellen. Prüfen Sie die Verzeichnisse und Institutionen Ihrer Branche und halten Sie Ihre Unternehmensangaben konsistent.
Auch strukturierte Daten vom Typ LocalBusiness können Fakten wie Adresse und Öffnungszeiten ausdrücken. Google dokumentiert deren Einsatz; einen Nutzen für ChatGPT haben wir mit unserem Experiment nicht getestet. Leitfaden zu strukturierten Daten
Messen Sie jede Art von Sichtbarkeit
Wiederholen Sie realistische Prompts und halten Sie fest, ob Ihr Unternehmen im Text empfohlen, auf einer Karte gezeigt oder über eine Quellenangabe verlinkt wird. Ordnen Sie die richtige Filiale über Adresse oder Place-ID zu.
Unsere Tests zeigen, dass diese Ergebnisse auseinanderfallen können. Wer die Sichtbarkeit verbessern will, muss zuerst wissen, welches Ergebnis er misst. Der kostenlose AI Visibility Check von scaile ist ein Einstieg, um zu verfolgen, ob KI-Antworten Ihr Unternehmen nennen.
Häufig gestellte Fragen
Zeigt ChatGPT bei lokalen Suchen immer eine Karte?
Nein. Alle 12 Haupt-Prompts mit Empfehlung und Stadt erzeugten Karten, gegenüber 3/12 Empfehlungen ohne Stadt und 0/12 Definitionen. Auch die Textanweisung bei Apotheken führte zu Empfehlungen ohne Karte. Das sind beobachtete Ergebnisse, keine garantierte Regel.
Nutzt ChatGPT ein eigenes Karten-Tool?
Sowohl Antworten mit Karte als auch reine Textantworten zeigten Aufrufe von web.run. Wir sahen auch map_search_model_queries, das aber ein Metadatenfeld ist. Es belegt keinen separaten, aufrufbaren Karten-Endpunkt und legt nicht alle internen Tool-Argumente offen.
Nutzt ChatGPT Daten von Google Maps?
Unsere abgeglichenen Stichproben hatten Google-kompatible Place-IDs sowie übereinstimmende Bewertungen und Rezensionszahlen. Das spricht für eine Verbindung zu Google-kompatiblen Unternehmensdaten, benennt aber den Lieferanten nicht. Wir beobachteten außerdem einen Datensatz mit tripadvisor-feed.
Gibt es auch Überschneidungen mit Yelp?
Ja. Vier ausgewählte Unternehmen stimmten über die Straßenadresse mit Yelp überein. Eine Bewertung passte, aber keine der vier Rezensionszahlen. In unseren 50 erfassten Gesprächen tauchten keine Yelp-URLs oder befüllten Yelp-spezifischen Felder auf. Das belegt überschneidende Unternehmen, aber nicht, dass Yelp die angezeigten Rezensionsdaten lieferte.
Steht das am besten bewertete Unternehmen an erster Stelle?
In unserer Stichprobe meist nicht. Von den 11 Haupt-Stadtlisten mit Bewertung an jedem Punkt begannen 10 mit einem Unternehmen, das schlechter bewertet war als ein anderes in der Liste. Eine Liste folgte tatsächlich einer absteigenden Bewertungsreihenfolge. Bewertungen können die Auswahl dennoch beeinflussen; die Datensätze legen die Gewichtung nicht offen.
Kann ein Unternehmen empfohlen werden, ohne auf der Karte zu erscheinen?
Ja. Im wiederholten CRM-Test empfahl ChatGPT Shore in einem zusätzlichen Satz, ließ es aber unter den fünf Kartenpunkten weg. Erfassen Sie schriftliche Empfehlungen getrennt von Kartenauftritten.
Findet ChatGPT Unternehmen in der Nähe, ohne dass der Prompt eine Stadt nennt?
Ja. Drei von 12 Haupt-Empfehlungen ohne genannte Stadt erzeugten Münchner Karten. Ein separater Apotheken-Prompt mit „in meiner Nähe“ tat das ebenfalls. Die vier neuesten Tests ohne Stadt fragten stattdessen nach einer Stadt oder einem Stadtteil. Die Mitschnitte belegen nicht, woher der abgeleitete Standort stammt.
Warum liefert dieselbe Frage andere Unternehmen?
Unser wiederholter Apotheken-Prompt veränderte sowohl die Auswahl als auch die Zahl der sichtbaren Web-Aufrufe. Aus den Streams lässt sich nicht herauslesen, ob Generierungsvariabilität, Änderungen beim Abruf oder verborgene Ranking-Logik die Ursache sind. Wiederholen Sie Prompts, bevor Sie Schlüsse über Sichtbarkeit ziehen.
Was sollte ein lokales Unternehmen optimieren?
Halten Sie Unternehmensprofile korrekt und veröffentlichen Sie klare, nützliche Angaben zu tatsächlichen Leistungen, Standorten, Öffnungszeiten und Buchung. Pflegen Sie relevante Branchenverzeichnisse. Das sind praktische Empfehlungen aus den beobachteten Eingaben; ihre ursächliche Wirkung auf ChatGPT-Empfehlungen haben wir nicht gemessen.
Gibt es eine öffentliche API, um diese Untersuchung nachzustellen?
Die getesteten Routen sind interne ChatGPT-Endpunkte. /backend-api/f/conversation trug das Such-Gespräch; /backend-api/sidebar/conversation bediente die Detailansicht eines ausgewählten Unternehmens. Die Studie belegt für keine der beiden Routen einen unterstützten öffentlichen Vertrag.
Wie breit gelten diese Ergebnisse?
Die Studie umfasst 50 Gespräche: 36 Haupttests in 12 Branchen und drei Prompt-Typen, acht Wiederholungen und sechs Formulierungsvarianten bei Apotheken. Sie nutzten ein Konto, deutsche Prompts und einen Münchner Forschungskontext. Diese kleinen Stichproben in fester Reihenfolge sind keine Auslöseraten für die Gesamtheit und kein Beweis für verborgene Server-Logik.
Technischer Anhang
Die beiden Endpunkte haben unterschiedliche Aufgaben
| Beobachtete Anfrage | Rolle in den Mitschnitten |
|---|---|
POST /backend-api/f/conversation | Den Gesprächs-Prompt senden; den gestreamten Antwort-Text, Suchmetadaten und optionale Unternehmens- bzw. Kartenkomponenten empfangen. |
POST /backend-api/sidebar/conversation | Mehr Informationen zu einem einzelnen ausgewählten Unternehmen abrufen, anhand von Name, Standort bzw. Adresse und Gesprächs-/Nachrichtenkontext. |
Das Folgende ist ein gekürzter Auszug der normalen Suchanfrage, kein vollständiges Rezept zum Nachspielen:
{
  "action": "next",
  "model": "gpt-6-thinking",
  "history_and_training_disabled": true,
  "temporary_chat_requests_personalization": false,
  "messages": [{
    "author": { "role": "user" },
    "content": {
      "content_type": "text",
      "parts": ["Welche Apotheken in München empfiehlst du?"]
    }
  }]
}
Das Anliegen steht in messages[].content.parts. Das normale Auslöse-Experiment enthielt kein map_search_params. Der vollständig erfasste Body enthält außerdem Client-Kontext, eine Kennung der übergeordneten Nachricht und weitere Felder.
Ein separater Parametertest ergänzte latitude, longitude, latitude_span, longitude_span und search_here innerhalb von map_search_params. Er lieferte 11 Place-IDs und Beschreibungen, aber keine nutzbare angezeigte Karte. Der Test zeigt eine akzeptierte Variation der Anfrage; er belegt keine stabile öffentliche API.
Die Sidebar-Anfrage nutzte stattdessen category: "generic_entity", generic_entity_params.category: "local_business", einen Unternehmens-name, Adresse bzw. Standort und Gesprächs-/Nachrichten-IDs. Sie schlägt eine ausgewählte Entität nach; sie ist nicht der hier gemessene Ablauf zur Kategoriesuche.
Was wir aus dem Stream lesen können
Der Content-Type der Antwort war text/event-stream. Server-Sent Events (SSE) liefern Updates, während die Antwort entsteht. Ein Event entspricht nicht einer Suche, einem Unternehmen oder einer fertigen Nachricht.
- Nachrichten-Updates rekonstruieren, statt wiederholte Momentaufnahmen als neue Aufrufe zu zählen.
- Sichtbare Assistenten-Nachrichten an
web.runidentifizieren. Diese zählen als sichtbare Aufrufe. - Anfrage- und Ergebnis-Metadaten der Tool-Nachrichten lesen. Vollständige Tool-Argumente fehlten häufig.
- Die rekonstruierte Antwort auf Unternehmensdatensätze und Kartenkomponenten prüfen, in diesen Mitschnitten auch
MapWidgetV2. - Die Komponenten mit der tatsächlichen Oberfläche vergleichen. Alle 50 Ergebnisse (Karte oder keine Karte) stimmten mit unseren Live-Beobachtungen überein. Vollständige DOM-Schnappschüsse nach Abschluss liegen für 49 vor; für den ersten zusätzlichen Bäckerei-Durchlauf gibt es einen lokalen Accessibility-Tree-Diff und eine Kartenbeobachtung im Tool-Protokoll.
Das ist unser Leseverfahren, keine Behauptung, dass jede Server-Stufe in dieser Reihenfolge abläuft. Updates können sich überlagern, und der Client erhält nur einen Teil der Server-Aktivität.
Die 50 Mitschnitte enthielten 4.184 SSE-Events. 28 Durchläufe zeigten Suchaktivität, mit 39 sichtbaren web.run-Aufrufen. 24 erzeugten Karten mit 146 Auftritten von Kartendatensätzen. Alle 50 endeten mit HTTP 200, [DONE] und message_stream_complete.
Warum Metadaten zu Kartensuchen kein vollständiges Protokoll der Kartensuche sind
search_model_queries und map_search_model_queries sind sichtbare Metadatenfelder. Ihre Namen belegen weder getrennte aufrufbare Endpunkte noch getrennte Tool-Implementierungen.
Im Durchlauf „Apotheken in meiner Nähe“ war der einzige sichtbare Suchstring:
Apotheke Notdienst Deutschland offizielle Apothekensuche aponetEr erschien in beiden Feldern. Dennoch zeigte die Antwort fünf Apotheken in München, obwohl die Stadt im sichtbaren String fehlte. In diesem normalen Durchlauf gab es keine Metadaten zu Kartenparametern. Das Anfragefeld lässt sich daher nicht als vollständige Aufzeichnung der geografischen Abrufeingaben behandeln.
In einem anderen Durchlauf enthielt map_search_model_queries eine Verbraucherratgeber-Anfrage zu Handwerkern und Kosten von Notdiensten. Am vorsichtigsten lässt sich sagen: Diese Felder legen anfragebezogene Metadaten offen, deren Herkunft unvollständig ist. Sie verraten nicht den vollständigen Ranking-Algorithmus auf dem Server.
Alle 12 Umformulierungen der Haupt-Stadtsuchen
Exakte Strings aus search_model_queries, pro Durchlauf und Stichwortkategorie einmal gezählt. Die finalen Felder map_search_model_queries sind aus der Stichwortstatistik ausgeschlossen.
| Branche | Sichtbarer Suchstring |
|---|---|
| Apotheken | München Apotheke Hauptbahnhof Marienplatz Öffnungszeiten Apotheke offiziell 2026 |
| Restaurants | München beste Restaurants 2026 Empfehlungen bayerisch modern Michelin Michelin Guide |
| Zahnärzte | München Zahnarzt Empfehlungen Bewertungen jameda Doctolib München Zahnärzte 2026 |
| Klempner | München seriöse Sanitärbetriebe Klempner Reparaturen Bewertungen Handwerkskammer |
| Steuerberater | Steuerberater München Kanzlei Privatpersonen Selbständige Unternehmen Empfehlungen Bewertungen 2026 |
| Hotels | best hotels Munich 2026 luxury boutique central affordable reviews Hotel Torbräu Cortiina Louis 25hours Motel One |
| Autowerkstätten | beste freie Autowerkstatt München Bewertungen Empfehlungen 2025 2026 |
| CRM-Software | CRM Software Hersteller München CAS? cobra? CentralStationCRM München Anbieter CRM München und München CRM Software Anbieter eigene Software München evalanche update? snapADDY München CRM Anbieter |
| Bäckereien | beste Bäckereien München 2025 2026 Brot Sauerteig Brezen Empfehlungen |
| Friseursalons | beste Friseure München Empfehlungen 2025 2026 Salons Bewertungen Treatwell |
| Fitnessstudios | Fitnessstudio München FitX Fit Star McFIT body soul Fitness First Elements Preise 2026 Standorte |
| Blumenläden | beste Blumenläden München Floristik Empfehlungen 2025 2026 |
Die Kodierregeln behalten die ursprünglichen Textabgleiche ohne Beachtung der Groß- und Kleinschreibung bei. „Benannte Ratgeber oder Institutionen“ zählt Jameda, Doctolib, Michelin oder Handwerkskammer. Treatwell steht in der Friseur-Anfrage, liegt aber außerhalb dieser festen Kategorie; wir weisen es als zusätzliche Beobachtung aus, statt die Regel stillschweigend zu ändern.
Grenzen des Studiendesigns und was wir nicht belegt haben
Die gesamte Studie umfasst 50 frische Gespräche, erhoben in drei Durchgängen: 34 erste Tests, acht zusätzliche Stadtempfehlungen und acht zusätzliche Tests ohne Stadt bzw. mit Definitionsfrage. Das ausgewogene Hauptpanel besteht aus 36 Gesprächen: 12 Branchen × drei Absichten. Acht Wiederholungstests umfassen Empfehlungs- und Definitions-Wiederholungen bei Apotheken und CRM sowie je eine zusätzliche Stadtempfehlung für Bäckereien, Friseursalons, Fitnessstudios und Blumenläden. Sechs Apotheken-Varianten testen Formulierungen mit Stichwort, „in der Nähe“, Kategorie plus Stadt, Online, nur Text und ausdrücklicher Karte. Ein reiner Oberflächen-Vortest ist ausgeschlossen.
Das erfasste Anfragemodell war gpt-6-thinking; die Oberfläche zeigte Medium als Aufwand an. Die Anfragen enthielten kein explizites Feld für den Denkaufwand. Es waren temporäre Chats mit deaktivierter Personalisierung, in einem Konto, überwiegend zu München und auf Deutsch. Der Browser-Client meldete client_contextual_info.app_surface: "codex_browser".
Die Erhebungsreihenfolge war fest und nicht randomisiert. Der erste Durchgang nutzte bis zu zwei gleichzeitige isolierte Tabs; die Erweiterungen liefen nacheinander. Jede Hauptzelle hat einen Test. Die Gesamtwerte decken alle 50 ab; Hauptvergleiche nutzen den ersten Test je Branche und Absicht, damit wiederholte Branchen kein zusätzliches Gewicht erhalten. Diese Zahlen beschreiben diese Pilotstudie und schätzen keine Auslösewahrscheinlichkeiten für die Gesamtheit.
Der ältere Formattest, die Google-Prüfung von acht Unternehmen und der Parametertest sind getrennte Kohorten. Sie werden nicht zu einer größeren Erfolgsquote zusammengefasst. Bei den Google-Vergleichen blieben gesponserte Ergebnisse außen vor, es wurden nur die ersten 20 organischen Einträge erfasst, und Standort, Zeitpunkt oder Oberflächensprache waren nicht vollständig angeglichen.
Wir haben browsersichtbaren Datenverkehr und das Verhalten der Oberfläche beobachtet. Serverprotokolle von OpenAI, Lieferantenverträge, vollständige Tool-Eingaben oder Ranking-Gewichte hatten wir nicht. Wir haben kein kausales Optimierungsexperiment durchgeführt und weder Traffic noch Leads oder Conversions gemessen.
Gespeicherte SSE-Dateien behalten die Event-Rahmung, schwärzen aber JSON-Nutzdaten und serialisieren sie neu; sie sind keine byte-genauen Originale. Das Belegpaket enthält Anfrageauszüge, rekonstruierte Nachrichten, Zusammenfassungen je Durchlauf, Oberflächenbelege und geschwärzte Streams. Das Register hält die Hashes der Quellen fest. Authentifizierungs-Header sind nicht enthalten.
Was die tieferen technischen Tests zeigten
Diese ergänzenden Tests stützen sich auf frühere Oberflächenbeobachtungen, historische Streams und gespeicherten Client-Code. Sie sind vom Panel mit 50 Gesprächen getrennt und ändern dessen Bezugsgrößen nicht.
Das Öffnen der Details kann die ursprünglichen Kartendaten ersetzen. Für die International Pharmacy Hauptbahnhof zeigte die Karte bei der Suche 4,6 Sterne und 261 Rezensionen. Bei zwei Detailaufrufen startete das Panel beim Laden mit 4,6 und wechselte dann auf 4,3. Der gespeicherte Client-Code stützt, dass ein anfänglicher Platzhalter ersetzt wird, wenn das geladene Unternehmen über ID oder normalisierten Namen passt. Der serverseitige Grund für den Unterschied bei der Bewertung bleibt unbekannt.
Ein sichtbares Kartenlabel ist nicht die Empfehlungsreihenfolge. Der untersuchte Client-Code priorisiert ausgewählte oder überfahrene Labels, danach Öffnungsstatus und Bewertung, und blendet Labels aus, die sich auf dem Bildschirm überlappen. Das ist eine Darstellungsregel. Sie erklärt nicht, welche Unternehmen der Server abgerufen hat oder warum die Antwort sie empfahl.
Ein Cache-Flag beweist keine Aktualität. Historische Sidebar-Antworten markierten das Wissen zur Entität als gecacht, während der Unternehmensdatensatz from_cache: false meldete. Eine Abfrage vom 8. Oktober nutzte eine Beschreibung wieder, die am 30. September erfasst wurde. Verschiedene Flags können verschiedene Ebenen beschreiben; diese Beobachtungen belegen keine Cache-Lebensdauer von acht Tagen.
Das Speichern des Live-Streams ist wichtig. In drei früheren Vergleichen fehlten in später gespeicherten Gesprächsantworten beide Anfragemetadaten-Felder, obwohl die Live-Streams sie gezeigt hatten. Wer nur die gespeicherte Antwort liest, hätte diesen Beleg verloren. Deshalb halten unsere neuen Tests Stream, rekonstruierte Nachrichten und Oberflächenbeobachtungen zusammen fest.
Umfang der Untersuchung: 50 frische, temporäre ChatGPT-Gespräche in einem Konto, erhoben am 9. Oktober 2026 mit gpt-6-thinking bei mittlerem Aufwand, überwiegend deutsche Prompts zu München. Diese Beobachtungen beschreiben diesen Aufbau, kein allgemeingültiges ChatGPT-Ranking und keinen kontrollierten Nachweis einer Wirkung von Content.