Welche Prompts man für eine Marke trackt und wie man misst, was sich verändert hat
Kurz gefasst
Welche Prompts sollte man für eine Marke tracken, und wie viel zählt jeder einzelne? Das ist das Playbook, das wir für jeden Kunden nutzen: derselbe Prozess für jede Marke, ein individuelles Ergebnis. Es beantwortet sieben Fragen, von den Bausteinen einer Kauffrage bis zur Messung vorher und nachher.
Wichtige Erkenntnisse
Echte Kauffragen statt erfundener Prompts: Wir finden sie über die Bausteine jedes Angebots: Varianten, Produkttypen, Eigenschaften, Bedürfnisse, Zielgruppen und Kontext.
Gruppiert und gewichtet: Prompts bilden ab 0,93 Ähnlichkeit Kaufsituationen, und jede Situation zählt nach ihrem Suchvolumen. Prompts mit Marke bekommen einen eigenen Score.
Die Anzahl folgt der Genauigkeit: Etwa 25 echte Prompts pro Angebot ergeben ±10 Punkte, 100 ergeben ±5.
Dieselben Prompts vorher und nachher: Cluster, an denen wir nicht gearbeitet haben, sind die Kontrolle. In einem Test ohne Content-Änderung fand die Methode keine Veränderung.
Beispielmarke: Porsche. Porsche ist kein Kunde von scaile. Alle Beispiele in diesem Artikel sind illustrativ.
Was wir machen
GEO ist vieles, aber nicht standardisiert. Generative Engine Optimization ist ein sehr vielfältiges und individuelles Feld; jede Marke braucht eigenen Content. Deshalb müssen wir unsere Kunden wirklich verstehen, bevor wir etwas für sie bauen. Wir müssen genau herausfinden, was ein einzelner Kunde verkauft, an wen und in welchem Kontext. Und all das müssen wir testen.
Deshalb haben wir ein Playbook entwickelt, das für jeden Kunden eine Frage beantwortet: Welche Prompts sollten wir tracken, und wie viel zählen sie? Der Prozess ist für jede Marke derselbe, das Ergebnis ist für jeden Kunden individuell.
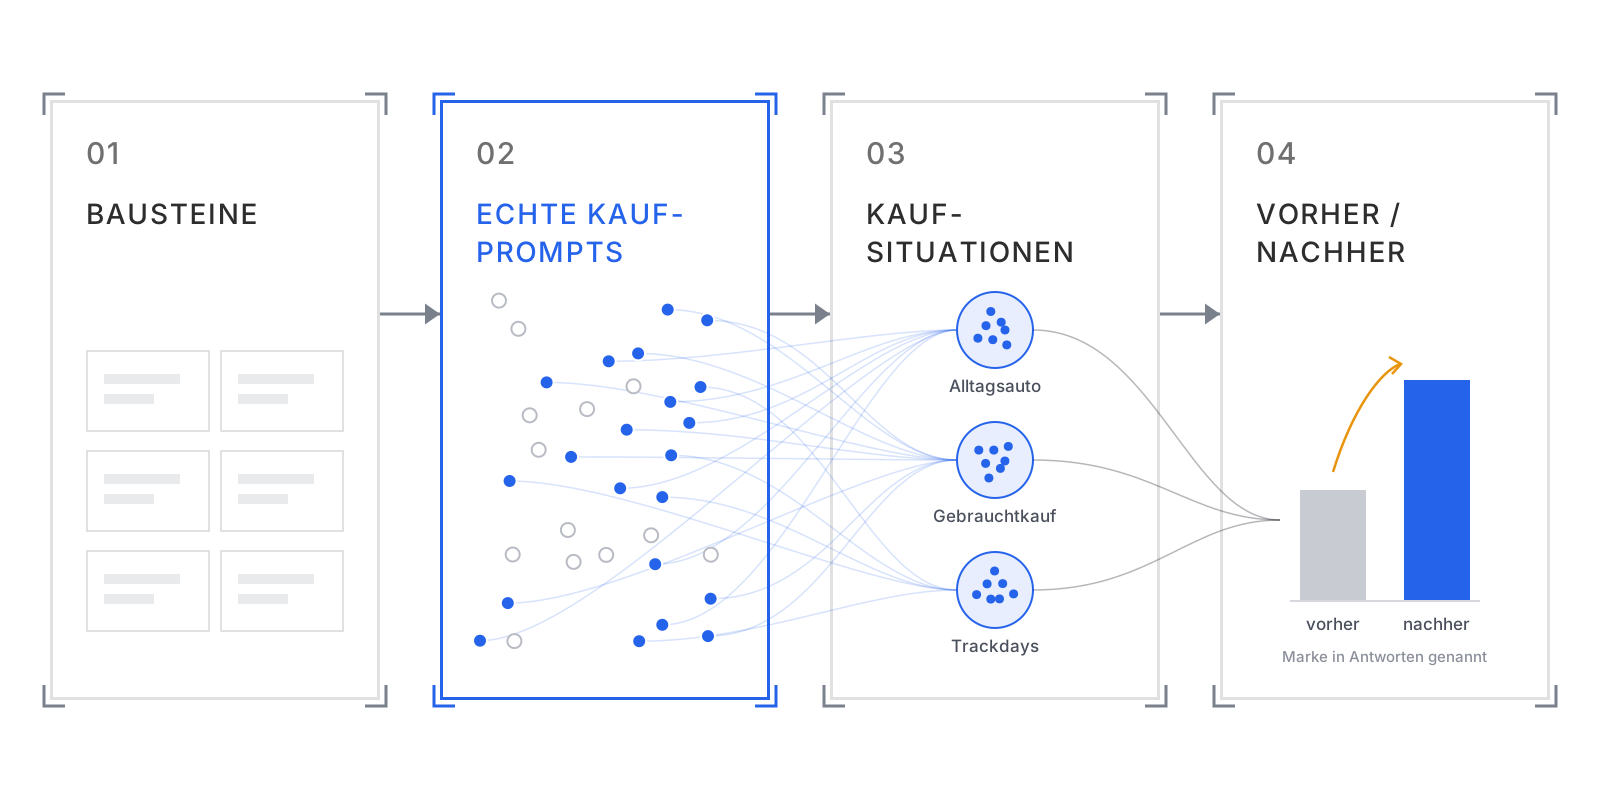
Das Playbook hat vier Phasen: die Fragen sammeln, den Test planen, messen und prüfen, was unser Content verändert hat. Dieser Artikel geht durch alle vier Phasen und beantwortet dabei sieben Fragen.
1. Was sind die Bausteine einer Kauffrage?
Am Anfang legen wir alle Angebote einer Marke fest. Dazu kommt eine Gruppe für Fragen zur Marke allgemein.
Für jedes Angebot sammeln wir die ersten Keywords in einem festen Raster: Varianten, Produkttypen, Eigenschaften, Bedürfnisse und Pain Points, Zielgruppen (ICPs) und Kontext.
Für den 911 sieht das so aus: Varianten sind Carrera, 4, S, 4S, Turbo und Turbo S. Produkttypen sind Coupé, Cabriolet und Targa. Eigenschaften sind Sportwagen, Beschleunigung, Preis, Sicherheit und Verbrauch. Bedürfnisse sind schnell fahren, Wohlstand zeigen, einen Bonus ausgeben oder Trackdays. Zielgruppen sind wohlhabende Menschen, Autofans und Pendler. Kontext ist neu, gebraucht oder Leasing.
Warum dieses Raster? Unser Ziel ist, alle Fragen zu finden, die Menschen stellen könnten. Wer eine Kauffrage zu einem Produkt hat, muss es irgendwie beschreiben: das Modell, die Variante, eine Eigenschaft, ein Bedürfnis, wer man ist oder die eigene Kaufsituation. Jede dieser Beschreibungen ist ein Wert in einer unserer Kategorien. Jeder relevante Prompt enthält also mindestens eines unserer Keywords oder eine Kombination aus mehreren. Das folgt der facettierten Klassifikation, bei der Klassen aus Bausteinen gebildet werden (Hjørland, ISKO). Es macht unsere Aufgabe leichter: Statt alle Prompts zu finden, müssen wir alle Bausteine finden.

2. Wie findet man echte Prompts?
Wir kombinieren die Keywords aus dem Raster und suchen damit nach echten Prompts. Wir beginnen mit kurzen Kombinationen und machen sie Schritt für Schritt länger. Das machen wir einmal mit Marke (mit Porsche oder 911) und einmal ohne. Für jede Kombination suchen wir dort, wo Menschen wirklich fragen: in Chat-Logs (WildChat, LMSYS), auf Reddit, in Foren, in Google-Ergebnissen und in internen Daten aus Sales-Calls und vom Kunden.
Dann klassifizieren wir jeden gefundenen Text. Erstens: Ist es ein echter Prompt oder eine Suchanfrage? Zweitens: Wie viel Kaufabsicht hat er: keine, leichte, mittlere oder klare? Wir behalten nur echte Prompts mit mittlerer oder klarer Kaufabsicht, die zum Angebot passen.
Beispiel:
- Mit „Cabriolet“ (Produkttyp) haben wir „cabriolet alltagsauto“ gefunden. Das ist eine Suchanfrage. Raus.
- Mit „Cabriolet + Alltagsauto“ (Produkttyp + Bedürfnis) haben wir „Ich fahre jeden Tag 40 km zur Arbeit. Welches Cabriolet macht Spaß und ist trotzdem bequem genug dafür?“ gefunden. Das ist ein Prompt mit mittlerer Kaufabsicht. Bleibt.
- Mit „911 GTS“ (Angebot + Variante) haben wir „Wie schnell ist ein 911 GTS?“ gefunden. Das ist ein Prompt, aber ohne Kaufabsicht. Raus.
- Mit „911 GTS + erster Porsche“ (Angebot + Variante + ICP) haben wir „Erster Porsche, Budget um die 150.000 €. Soll ich einen 911 GTS oder einen Carrera S kaufen?“ gefunden. Das ist ein Prompt mit klarer Kaufabsicht. Bleibt.

3. Woher wissen wir, dass wir genug gefunden haben?
Die ersten Keywords sind nur der Anfang. In jeder Runde finden wir neue Keywords, zum Beispiel aus „Ähnliche Fragen“ und „Andere suchten auch nach“, und suchen damit erneut nach echten Kauf-Prompts. Keywords sind der Köder, Kauf-Prompts der Fang. Wir hören auf, wenn eine Runde weniger als 5 % oder weniger als 3 neue Kauf-Prompts bringt.
Wir haben diese Schleife an 10 Angeboten mit 4.009 Kauf-Prompts getestet. Die Start-Keywords allein fanden nur 53 % der Kauf-Prompts, die die ganze Schleife gefunden hat. Die meisten Prompts kommen früh: 85 % nach zwei Runden. Runden nach dem Stopp hätten nur 0,2 % mehr gebracht.
Außerdem haben wir unsere Methode mit freier Suche durch unabhängige Researcher verglichen, bei gleichem Budget (60 Suchen pro Angebot) und in einem Textarchiv, das beide vollständig durchsucht haben (Reddit, Foren, Chat-Logs). Unsere Methode fand 97 % der Kauf-Prompts, die die freie Suche fand (2.101 von 2.176), und mindestens 291, die die freie Suche verpasst hat.
Keywords aus dem Raster, die nie in einem echten Prompt vorkommen, kommen auf eine Lückenliste. Sie zeigt, wo Käufer noch nicht gefragt haben oder wo wir sie noch nicht gefunden haben.

4. Wie gruppiert man die Prompts?
Für jedes Angebot gruppieren wir die Prompts nach Bedeutung in Kaufabsichten. Jeder Prompt wird zu einem Vektor, und Prompts mit ähnlicher Bedeutung liegen nah beieinander. Ein Cluster ist eine Kaufsituation, zum Beispiel „Alltagsauto“ oder „Gebrauchtkauf“. Später sehen wir, in welchen Situationen eine Marke sichtbar ist und in welchen nicht.
Die Schwelle liegt bei 0,93 Ähnlichkeit. Wir haben mehrere Schwellen an den KI-Antworten getestet: Wie ähnlich sind die Antworten auf Prompts im selben Cluster? Ab etwa 0,92 bis 0,94 machen feinere Cluster die Antworten kaum noch ähnlicher. Wir bekommen aber viel mehr Cluster mit nur einem Prompt, und die Cluster werden weniger stabil. Bei 0,93 waren die Antworten innerhalb eines Clusters etwa so ähnlich wie bei 0,95 (Antwortabstand 0,046 gegenüber 0,044), und die Cluster waren stabiler (0,94 gegenüber 0,91).
Ein Ergebnis hat uns überrascht: Selbst zwei sehr ähnliche echte Fragen bekommen unterschiedlichere Antworten als eine Frage und ihre Umformulierung. Ein Cluster ist also eine Gruppe mit derselben Kaufabsicht, nicht eine Gruppe mit derselben Antwort.

5. Wie viele Prompts braucht man?
Es gibt keine allgemeine Zahl für ein Unternehmen, aber eine für eine Genauigkeit. Der Fehler eines Mittelwerts wird mit mehr Prompts kleiner: SEM = σ / √N. σ ist die Streuung zwischen den Prompts. In unseren Tests liegt sie bei etwa 0,25, im schlechtesten Fall bei 0,5. Mit 95 % Sicherheit liegt der wahre Wert innerhalb von etwa ±2 × SEM. Wir brauchen also N = (σ / SEM)² Prompts.
- SEM 0,05: ±10 Punkte, 25 Prompts (σ = 0,25), 100 Prompts (σ = 0,5)
- SEM 0,04: ±8 Punkte, 40 / 157
- SEM 0,03: ±6 Punkte, 70 / 278
- SEM 0,025: ±5 Punkte, 100 / 400
- SEM 0,02: ±4 Punkte, 157 / 625
- SEM 0,01: ±2 Punkte, 625 / 2.500
Für ±10 Punkte brauchen wir also 25 echte Prompts pro Angebot, für ±5 Punkte schon 100. Bevor wir testen, legen wir fest, wie genau jedes Angebot sein muss.

6. Wie gewichtet man die Ergebnisse?
Gewichte lassen wichtige Situationen stärker zählen, damit der Score zeigt, was Käufer wirklich fragen. Wir nutzen sie zweimal. Cluster → Angebot: Jeder Cluster zählt nach seinem Suchvolumen (DataForSEO). Angebote → Marke: Jedes Angebot zählt nach seinem Marktgewicht und einem individuellen Kundengewicht.
- Score pro Cluster = Anteil der Antworten, die die Marke nennen.
- Score pro Angebot = Cluster-Scores mal ihre Gewichte, dann addiert.
- Score für die Marke = Angebots-Scores mal ihre Gewichte, dann addiert. Einmal mit den Kundengewichten, einmal mit den Marktgewichten.
Prompts mit Marke bekommen einen eigenen Score und werden nie in den Haupt-Score gemischt.
Die Gewichte entscheiden auch, wie viele Prompts jeder Cluster bekommt. Beispiel 911, 25 Prompts für ±10 Punkte:
- Alltagsauto: 50 % des Suchvolumens, 50 % × 25 = 12,5, getestet 13
- Gebrauchtkauf: 30 %, 7,5, getestet 8
- Trackdays: 20 %, 5, getestet 5
- Zusammen: 26 Prompts
Für mehr Sicherheit legen wir zuerst die Zahl der Prompts pro Cluster nach Gewicht fest und addieren dann, nicht umgekehrt. Für jeden Cluster gleich viele Prompts zu nehmen und danach zu gewichten, würde den Fehler vergrößern.
Wir testen nur echte Prompts, keine Umformulierungen. In unseren Tests brachte eine Umformulierung nur etwa ein Viertel der Information einer neuen echten Frage. Und manchmal hat sie etwas anderes gemessen: Eine echte Frage nach einem Blutdruckmessgerät, das seine Werte an eine App schickt, nannte die Marke in 20 von 20 Durchläufen, die Umformulierung „Empfiehl mir ein Blutdruckmessgerät mit Bluetooth“ nur in 5 von 20. Hat ein Cluster weniger echte Prompts als nötig, testen wir ihn mit dem, was er hat, geben eine größere Spanne an und suchen erneut nach dieser Kaufsituation.

7. Wie misst man, was sich verändert hat?
Wir messen über einen Endpunkt von OpenAI, bei dem das Modell seine Websuchen selbst formuliert (Fan-out). Jeder Prompt läuft 5-mal. Eine Nennung zählt, wenn der Markenname in der Antwort steht oder die Domain der Marke unter den zitierten Quellen ist.
Bevor die Content-Arbeit beginnt, schreiben wir auf, an welchen Clustern wir arbeiten. Nach der Content-Arbeit messen wir erneut, mit exakt denselben Prompts. Dann vergleichen wir pro Prompt: nachher minus vorher, und pro Cluster die mittlere Veränderung mit ihrem Fehler. Cluster, an denen wir nicht gearbeitet haben, sind die Kontrolle. Bewegen sie sich mit, ist es wahrscheinlich ein Modell-Update und nicht unser Content.
Um eine Veränderung von etwa 5 Punkten zu sehen, brauchen wir etwa 64 Prompts mit 5 Durchläufen pro Gruppe von Clustern. Die Veränderung eines einzelnen Prompts zwischen zwei Messungen streut um etwa 0,20 und lag nie über 0,25 (378 Prompts, dreimal gemessen).
Wir haben auch getestet, ob die Messung Veränderungen zeigt, die es nicht gab. Wir haben dieselben 378 Prompts dreimal ohne jede Content-Änderung gemessen (5.646 Antworten). Die Markenrate lag bei 0,202, 0,192 und 0,192. Nur 2 von 195 Cluster-Vergleichen wirkten signifikant, Zufall allein ergibt etwa 5 %, und nach Korrektur für multiples Testen keiner. Die Methode erfindet also keine Veränderungen.

Wie es hilft
- Die richtigen Prompts. Das Prompt-Set zeigt, was Käufer dieser Marke wirklich fragen, nicht was wir vermuten.
- Gewichte, die zählen. Kaufsituationen mit mehr Nachfrage zählen mehr.
- Bekannte Genauigkeit. Jede Zahl kommt mit ihrer Spanne, und wir wissen, wie viele Prompts wir dafür brauchen.
- Sichtbare Lücken. Keywords ohne echte Prompts zeigen, wo Käufer noch nicht fragen oder wo wir sie noch nicht gefunden haben.
Warum es stark ist
- Echte Fragen statt erfundener Prompts. Keywords zeigen nur, wo wir suchen. Was wir tracken, kommt von echten Käufern.
- Derselbe Prozess für jeden Kunden, ein individuelles Ergebnis. Eine Sportwagenmarke und ein Medizingerätehersteller bekommen sehr unterschiedliche Prompt-Sets.
- Ein festes Set. Weil sich das Set nicht ändert, können wir Messungen über die Zeit vergleichen und sehen, was unser Content verändert hat.
Ergebnis
Am Ende hat jeder Kunde:
- eine Karte von allem, was die Marke verkauft, mit Keywords in sechs Kategorien und zwei Gewichten pro Angebot,
- ein Prompt-Set aus echten Kauffragen, gruppiert in gewichtete Kaufsituationen,
- die Zahl der Prompts für die gewünschte Genauigkeit und ihre Aufteilung auf die Cluster,
- eine Lückenliste mit Keywords und Situationen ohne genug echte Prompts,
- eine Messung vorher und nachher, die zeigt, was unser Content verändert hat.
Was wir noch nicht wissen:
- Es gibt keine öffentlichen Daten dazu, wie oft ein bestimmter Prompt gestellt wird. Wir nutzen das Suchvolumen als Näherung für die Nachfrage.
- Bei 0,93 fand eine Blindbewertung 2 von 10 bis 12 Clustern, die verschiedene Kaufabsichten mischten. Wir lesen jeden Cluster und markieren gemischte.
- Der Schwellentest und die Wiederholungsmessungen liefen bisher an einer Marke.
- Wir wissen, dass die Methode keine Veränderungen erfindet. Ob sie jede echte Veränderung erkennt, braucht noch einen Test mit einer bekannten Content-Änderung.
- Die Antworten kommen aus einer API, nicht aus der ChatGPT-App. Modell-Updates können Antworten verändern, deshalb wiederholen wir Messungen und notieren die Modellversion.