Was ein großes Google-Update für GEO bedeuten würde
Kurz gefasst
Am 1. Oktober hat Google zwei Seiten seiner Dokumentation umgeschrieben: KI-Inhalte sollen von Hand geprüft werden, und gefälschte Autorenprofile gelten als Täuschung. Google hat kein Update angekündigt, aber Fachleute erwarten eines gegen KI-Massencontent und GEO-Tricks. Was sich geändert hat, was die Rater-Richtlinien wirklich sagen und was das für GEO bedeuten würde.
Wichtige Erkenntnisse
Am 1. Oktober hat Google zwei Seiten seiner Dokumentation umgeschrieben. KI-Inhalte sollen von Hand geprüft werden, und gefälschte Autorenprofile gelten als Täuschung.
KI an sich ist nicht das Problem. Googles Rater-Richtlinien geben Seiten ohne Aufwand, Originalität oder Mehrwert die schlechteste Bewertung, egal wie sie entstanden sind.
Google hat kein Update angekündigt. Fachleute wie Lily Ray erwarten eines gegen KI-Massencontent und GEO-Tricks. Inhalte mit eigenen Daten und echten Autoren sind so oder so die sicherere Wahl.
Was Google am 1. Oktober geändert hat
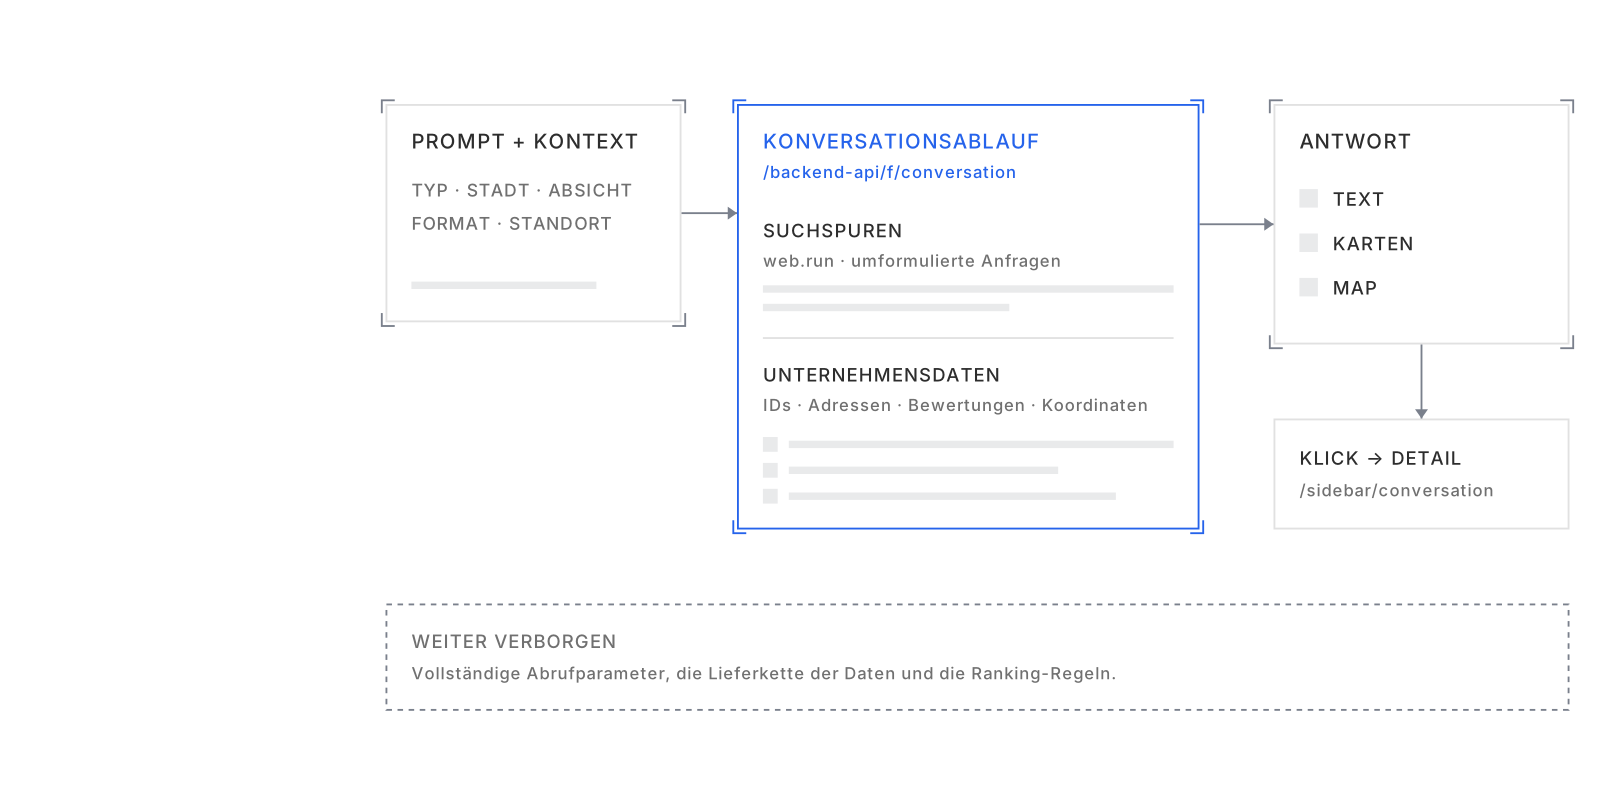
Am 1. Oktober hat Google zwei Seiten seiner Search-Dokumentation geändert. Die erste ist der Leitfaden zur Nutzung von KI-generierten Inhalten.
Dort steht jetzt: „It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing.“ Alle KI-Inhalte sollen also vor der Veröffentlichung von Hand auf Richtigkeit und Vertrauenswürdigkeit geprüft werden. Das gilt auch für Titel, Meta-Descriptions, strukturierte Daten und Alt-Texte von Bildern. Außerdem empfiehlt Google, offenzulegen, wie ein Inhalt entstanden ist.
Laut Googles Änderungsprotokoll enthält der Leitfaden jetzt „information from the Search Quality Raters guidelines“. Diese Richtlinien (aktuelle Version: 11. September 2025) erklären Googles menschlichen Prüfern, wie sie die Qualität von Seiten bewerten. Ihre Bewertungen ändern das Ranking nicht direkt. Google nutzt sie, um zu prüfen, ob die eigenen Algorithmen wie gewollt funktionieren.
Was sagen die Richtlinien also über KI? Sie nennen KI-Inhalte nicht an sich täuschend. Täuschend ist, über die Urheberschaft zu lügen.
Abschnitt 4.5.3 nennt Beispiele für täuschende Angaben über eine Website. Eines davon sind gefälschte Autorenprofile: „For example, AI generated content with made up “author” profiles (AI generated images or deceptive creator descriptions) in order to make it appear that the content is written by people.“ Gemeint sind KI-Inhalte mit erfundenen Autorenprofilen, die den Eindruck erwecken sollen, Menschen hätten sie geschrieben. In derselben Liste gelten auch falsche Angaben zur Expertise als Täuschung, etwa ein Autorenprofil, das sich fälschlich als medizinische Fachkraft ausgibt.
Die zweite Seite, die Google am 1. Oktober geändert hat, Creating helpful content, sagt jetzt dasselbe: Erfundene Autorenprofile sind „a form of deception“ und ein „signal of a low-quality page“, also Täuschung und ein Zeichen für eine minderwertige Seite.
Was die Rater-Richtlinien über KI-Inhalte sagen
- Die schlechteste Bewertung gibt es nur, wenn der Hauptinhalt ganz oder fast ganz kopiert, paraphrasiert, eingebettet, automatisch oder per KI erzeugt oder neu gepostet ist und dabei kaum Aufwand, kaum Originalität und kaum Mehrwert zeigt (Abschnitt 4.6.6).
- KI allein entscheidet nicht: „the use of Generative AI tools alone does not determine the level of effort or Page Quality rating.“
- Seiten, die in großer Zahl ohne eigenen Inhalt oder Mehrwert erstellt werden, bekommen die schlechteste Bewertung, „no matter how they are created“ (Abschnitt 4.6.5, Scaled Content Abuse).
Wie das in der Praxis aussieht
Die Richtlinien zeigen echte Seiten, die Prüfer mit der schlechtesten Note bewerten sollen. Bei vier davon geht es um KI. Die ersten beiden täuschen darüber, wer hinter ihnen steht, die letzten beiden zeigen fast keinen Aufwand:
- Eine Eltern-Seite, die keine ist. Ein Artikel über die Umstellung von Babys auf Vollmilch. Die Nutzungsbedingungen verraten: KI-geschriebene Artikel für „AI enthusiasts“, nicht für Eltern (S. 46).
- Ein Kaninchen-Blog, der über Tumore schreibt. Eine Seite von „rabbit lovers and breeders“ veröffentlicht Gesundheits-Q&As nach Schablone, hier über Eierstocktumore. Täuschend und paraphrasiert (S. 55).
- Eine unbearbeitete KI-Antwort. Ein Krebs-Artikel beginnt mit „As a language model, I don’t have real-time data…“ und bricht mitten im Satz ab (S. 55).
- Ein Hühner-FAQ. Sich wiederholende Fragen wie „Is 40 degrees too cold for chickens?“ mit Antworten, die nicht zueinander passen. Keine Spur eines menschlichen Redakteurs (S. 58).
Der Kaninchen-Blog und das Hühner-FAQ folgen demselben Muster. Laut den Richtlinien sind solche Q&A-Artikel ein verbreiteter Weg, Massencontent zu erzeugen: Fragen aus Quellen wie Googles „Ähnliche Fragen“ sammeln und mit unoriginellem, paraphrasiertem Text beantworten, oft mit generativer KI. Das FAQ-Format ist nicht das Problem. FAQs ohne eigene Antworten sind es.
Kommt ein großes Update?
Die Änderungen an der Dokumentation sind nicht das einzige Signal. Bei Search Central Live in Barcelona warnte Gary Illyes, Analyst bei Google, Massencontent werde zu einem größeren Problem als Linkspam. Das geht aus einer Zusammenfassung von John Campbell hervor, über die Search Engine Roundtable berichtet hat. Außerdem hat Google 2026 schon vier Spam-Updates ausgerollt, im ganzen Jahr 2025 nur eines, und die Abstände werden kürzer: 92, 55, dann 37 Tage. Das letzte begann am 24. September (Status Dashboard).
Die SEO-Beraterin Lily Ray sieht darin den Vorlauf zu einem großen Update: „a matter of when, not if.“ Ein Datum nennt sie nicht. Ihr Hauptargument ist ein Muster: Google hat seine Dokumentation oft kurz vor großen Updates geändert. Änderungen an den Rater-Richtlinien kamen 12 Tage vor dem Medic-Update 2018, eine Klarstellung der Spam-Richtlinien sechs Tage vor dem Core Update im Mai 2026. Sie erwartet, dass das Update auf KI-Massencontent ohne menschliche Prüfung zielt, auf erfundene Autoren-Personas, Seiten nach Schablone und GEO-Taktiken wie selbstbewerbende „Best of“-Listen, bezahlte Erwähnungen und automatisierte Reddit-Posts.
Ihre eigenen Daten deuten darauf hin, dass Googles KI schon auf eine dieser Taktiken reagiert. Bei 100 Suchen nach „best B2B software“ wurden Marken, die sich in ihrer eigenen Liste auf Platz 1 gesetzt hatten, im September in 83 % der Fälle aus der eigentlichen Empfehlung der AI Overview ausgelassen, im Juni waren es 69 %. Das ist eine einzelne Auswertung, kein Beweis. Sie zeigt aber, dass zitiert werden und empfohlen werden nicht dasselbe ist.
Unsere Einschätzung: Die Richtung ist klar. Inhalte, die etwas Neues beitragen, sollten gewinnen. Inhalte, die mit KI umschreiben, was es schon gibt, sollten verlieren.
Was das für GEO bedeuten würde
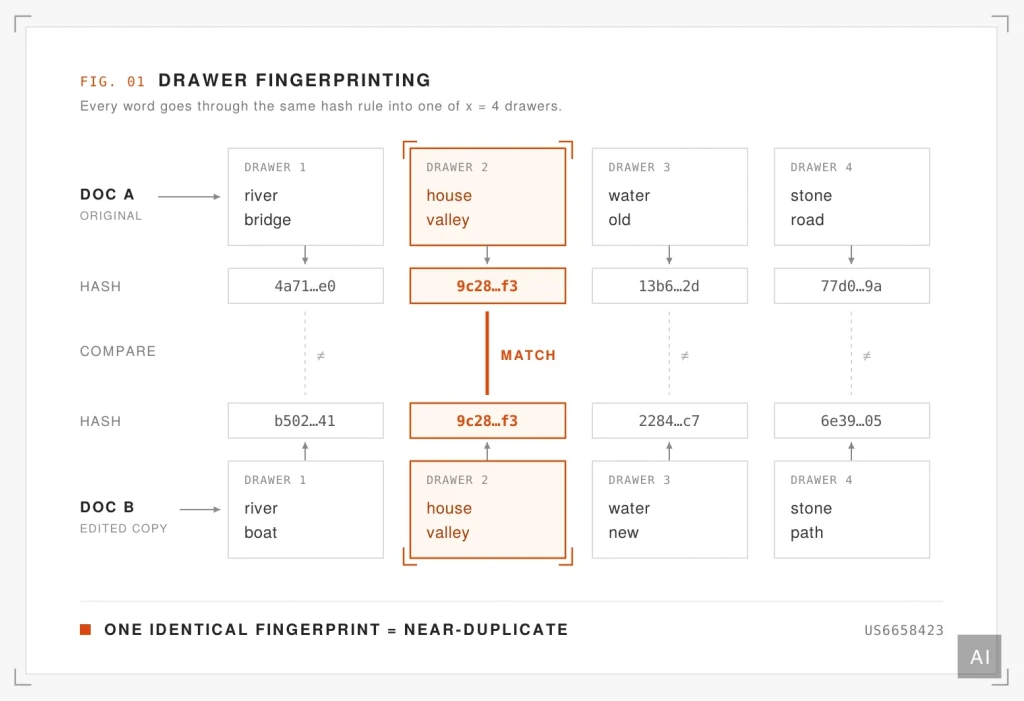
Wie erkennt Google kopierte Inhalte? Ein Google-Patent von 2001 zeigt die Grundidee. Eine Hash-Funktion sortiert die Wörter einer Seite in einige „Schubladen“, und jede Schublade bekommt einen Fingerabdruck. Haben zwei Seiten einen gleichen Fingerabdruck, gelten sie als Beinahe-Duplikate. Ändert man ein paar Wörter, passen die meisten Schubladen trotzdem noch.

Google hat bis 2008 Folgepatente angemeldet. Keines ist heute noch aktiv, und wie Google Duplikate heute erkennt, ist nicht öffentlich. Google sagt, es setze zunehmend KI gegen Spam ein.
Umformulieren hilft also nicht. Das Patent selbst beschreibt, wie sich Synonyme über die umgebenden Wörter finden lassen, und die Rater-Richtlinien nennen „synonymizing“ eine Form von Scaled Content Abuse. Paraphrasierte Inhalte gelten als kopiert, egal ob ein Mensch oder eine KI sie umgeschrieben hat.
Was das für GEO bedeutet:
- Kopien verlieren. Seiten, die nur in neuen Worten wiederholen, was andere schon sagen, dürften an Sichtbarkeit verlieren, in Google und in KI-Antworten.
- Eigene Substanz gewinnt. Eigene Daten, eigene Tests, echte Fälle und echte Autoren geben KI-Systemen einen Grund, Ihre Seite auszuwählen.
- Eigenwerbung geht nach hinten los. In Lily Rays Daten half die eigene „Best of“-Liste einer Marke vor allem der Konkurrenz: In 70 % der Fälle empfahl die AI Overview andere aus der Liste und ließ den Herausgeber weg.
Jetzt nachlegen
Google hat kein Update angekündigt, und es kommt vielleicht nicht in der Form, die viele erwarten. Wer sich aber die Richtung der jüngsten Änderungen ansieht, findet ein paar Schritte, die sich schon jetzt lohnen könnten. Und keiner davon schadet, wenn kein Update kommt ;)
- KI-Texte von Hand prüfen. Googles Leitfaden nennt die Faktenprüfung jetzt „critical“, auch für Titel, Meta-Descriptions, strukturierte Daten und Alt-Texte.
- Echte Autoren nennen. Echte Namen und echte Qualifikationen. Wenn kein einzelner Mensch einen Text geschrieben hat, ist eine ehrliche Team-Angabe vermutlich besser als eine erfundene Persona.
- Offenlegen, wie Inhalte entstehen. Google empfiehlt das dort, wo Leser es erwarten würden. Vorgeschrieben ist es nicht.
- Prüfen, was in großer Zahl veröffentlicht wurde. Seiten nach Schablone oder KI-Seiten ohne neuen Beitrag lassen sich verbessern, zusammenlegen oder entfernen.
- FAQs aus echten Fragen bauen. Fragen, die Menschen wirklich stellen, beantwortet mit etwas, das nur Sie beitragen können: eigene Daten, ein Test, ein echter Fall.
- Selbst-Rankings überdenken. Lily Ray erwartet, dass „Best of“-Listen mit dem Herausgeber auf Platz 1 und bezahlte Erwähnungen zu den Zielen gehören. Ihre Daten deuten darauf hin, dass sie schon jetzt eher der Konkurrenz helfen als dem Herausgeber.
Was wir noch nicht wissen: Google hat kein Update angekündigt, Zeitpunkt und Ziele sind offen. Ob Google das Patent von 2001 noch nutzt, ist nicht öffentlich. Lily Rays Zahlen zu den Listen stammen aus einer einzigen Auswertung von 100 Suchen nach B2B-Software.